DE EN
Künstliche Intelligenz (KI) Linux News Tech-Guide & Tipps

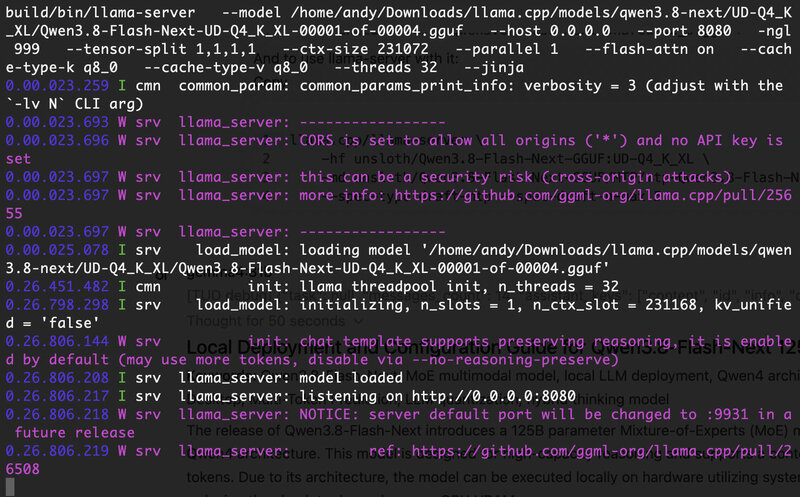
Qwen3.8-Flash-Next 125B-MoE-Modell lokalen betreiben mit Konfigurationsoptionen

21.09.2026, 10:56 • Von Andreas Bunen

Mit der Veröffentlichung von Qwen3.8-Flash-Next wird ein multimodales „Mixture-of-Experts“ (MoE)-Modell mit 125 Milliarden Parametern eingeführt, das auf der Qwen4-Architektur basiert. Dieses Modell ist für Reasoning ausgelegt und unterstützt ein Kontextfenster von bis zu 262.144 Tokens. Dank seiner Architektur kann das Modell lokal auf Hardware ausgeführt werden, die System-RAM oder Unified Memory nutzt, wodurch die absolute Abhängigkeit vom GPU-VRAM reduziert wird.

Guide Qwen3.8-Flash-Next 125B-MoE-Modell lokalen betreiben mit Konfigurationsoptionen
Neueste Artikel

Nintendos Strategie für die Switch 2

Wie Nintendo gegen Scalper vorgehen will

Immer wieder sind Scalper ein Ärgernis für Gamer, Hardware-Enthusiasten und Fans anderer Subkulturen. Im Zusammenhang mit dem lang ...


Neueste Testberichte nach Kategorie

Arbeitsspeicher Tests

Alle ansehen →

CPU-Kühler, Lüfter & AIO-Wasserkühlung Tests

Alle ansehen →

Kopfhörer, Headsets & Audio Tests

Alle ansehen →

Grafikkarten Tests

Alle ansehen →

Eingabegeräte Tests

Alle ansehen →

Mainboards Tests

Alle ansehen →

Monitore Tests

Alle ansehen →

Notebooks & MIni-PCs Tests

Alle ansehen →

NVMe, SSD & Speichermedien Tests

Alle ansehen →

Netzteile Tests

Alle ansehen →

PC-Gehäuse Tests

Alle ansehen →

Prozessoren Tests

Alle ansehen →

Smartphones & Tablets Tests

Alle ansehen →

Vergleichstests und Ratgeber

Tech-Guide & Tipps

Guide Qwen3.8-Flash-Next 125B-MoE-Modell lokalen betreiben mit Konfigurationsoptionen
Mit der Veröffentlichung von Qwen3.8-Flash-Next wird ein multimodales „Mixture-of-Experts“ (MoE)-Modell mit 125 Milliarden Paramete...