 Computer Forum
 Mistral Large 4 (Bild © Mistral)
Das aktualisierte Modell zeigt deutliche Verbesserungen bei Programmieraufgaben. Laut dem „Coding Agent Index“ von Artificial Analysis ist „Mistral Large 4“ nun das leistungsstärkste Open-Weights-Modell in seiner Kategorie und erreicht eine Punktzahl von 41 Prozent. Darüber hinaus weist das Modell eine höhere Token-Effizienz auf als konkurrierende Systeme; es benötigt im Durchschnitt 47 Prozent weniger Token als GLM-5.3, um vergleichbare Ergebnisse zu erzielen.
Im Bereich der Cybersicherheit ordnet der „Cyber Index“ von Artificial Analysis das Modell hinsichtlich seiner defensiven Fähigkeiten hinter Deepseek V4.1 Flash ein. Mistral Large 4 zeichnet sich jedoch durch strengere Sicherheitsvorkehrungen aus und weist im Vergleich zu anderen Modellen mit offenen Gewichten eine höhere Ablehnungsrate bei gefährlichen oder schädlichen Abfragen auf. Während die öffentliche Version diesen Sicherheitsmaßnahmen Vorrang einräumt, können Partnern spezifische Versionen mit offensiven Fähigkeiten für Penetrationstests zur Verfügung gestellt werden.
Modellarchitektur und technische Spezifikationen
Mistral Large 4 nutzt eine Mixture-of-Experts (MoE)-Architektur mit insgesamt 1 Billion Parametern. Das System ist mit 128 Experten aufgebaut, von denen pro Token vier aktiviert werden, sowie einem gemeinsamen Experten, der stets im Einsatz ist. Diese Konfiguration führt zu etwa 52 Milliarden aktiven Parametern pro Token.
Zu den technischen Merkmalen gehören:
- Kontextfenster: Das Modell unterstützt eine Kontextlänge von einer Million Token.
- Durchsatzoptimierung: Es wurde eine spekulative Dekodierung über Dspark (g+) implementiert, die den Durchsatz um bis zu 90 Prozent steigern kann.
- Bildverarbeitungsfunktionen: Ein neuer Bildverarbeitungs-Encoder ermöglicht es dem Modell, Bilder beliebiger Größe zu verarbeiten.
- Mehrsprachige Unterstützung: Das Modell unterstützt mehr als 160 Sprachen.
- Trainingsinfrastruktur: Der Trainingsprozess wurde mit 3.800 Grace-Blackwell-GPUs durchgeführt.
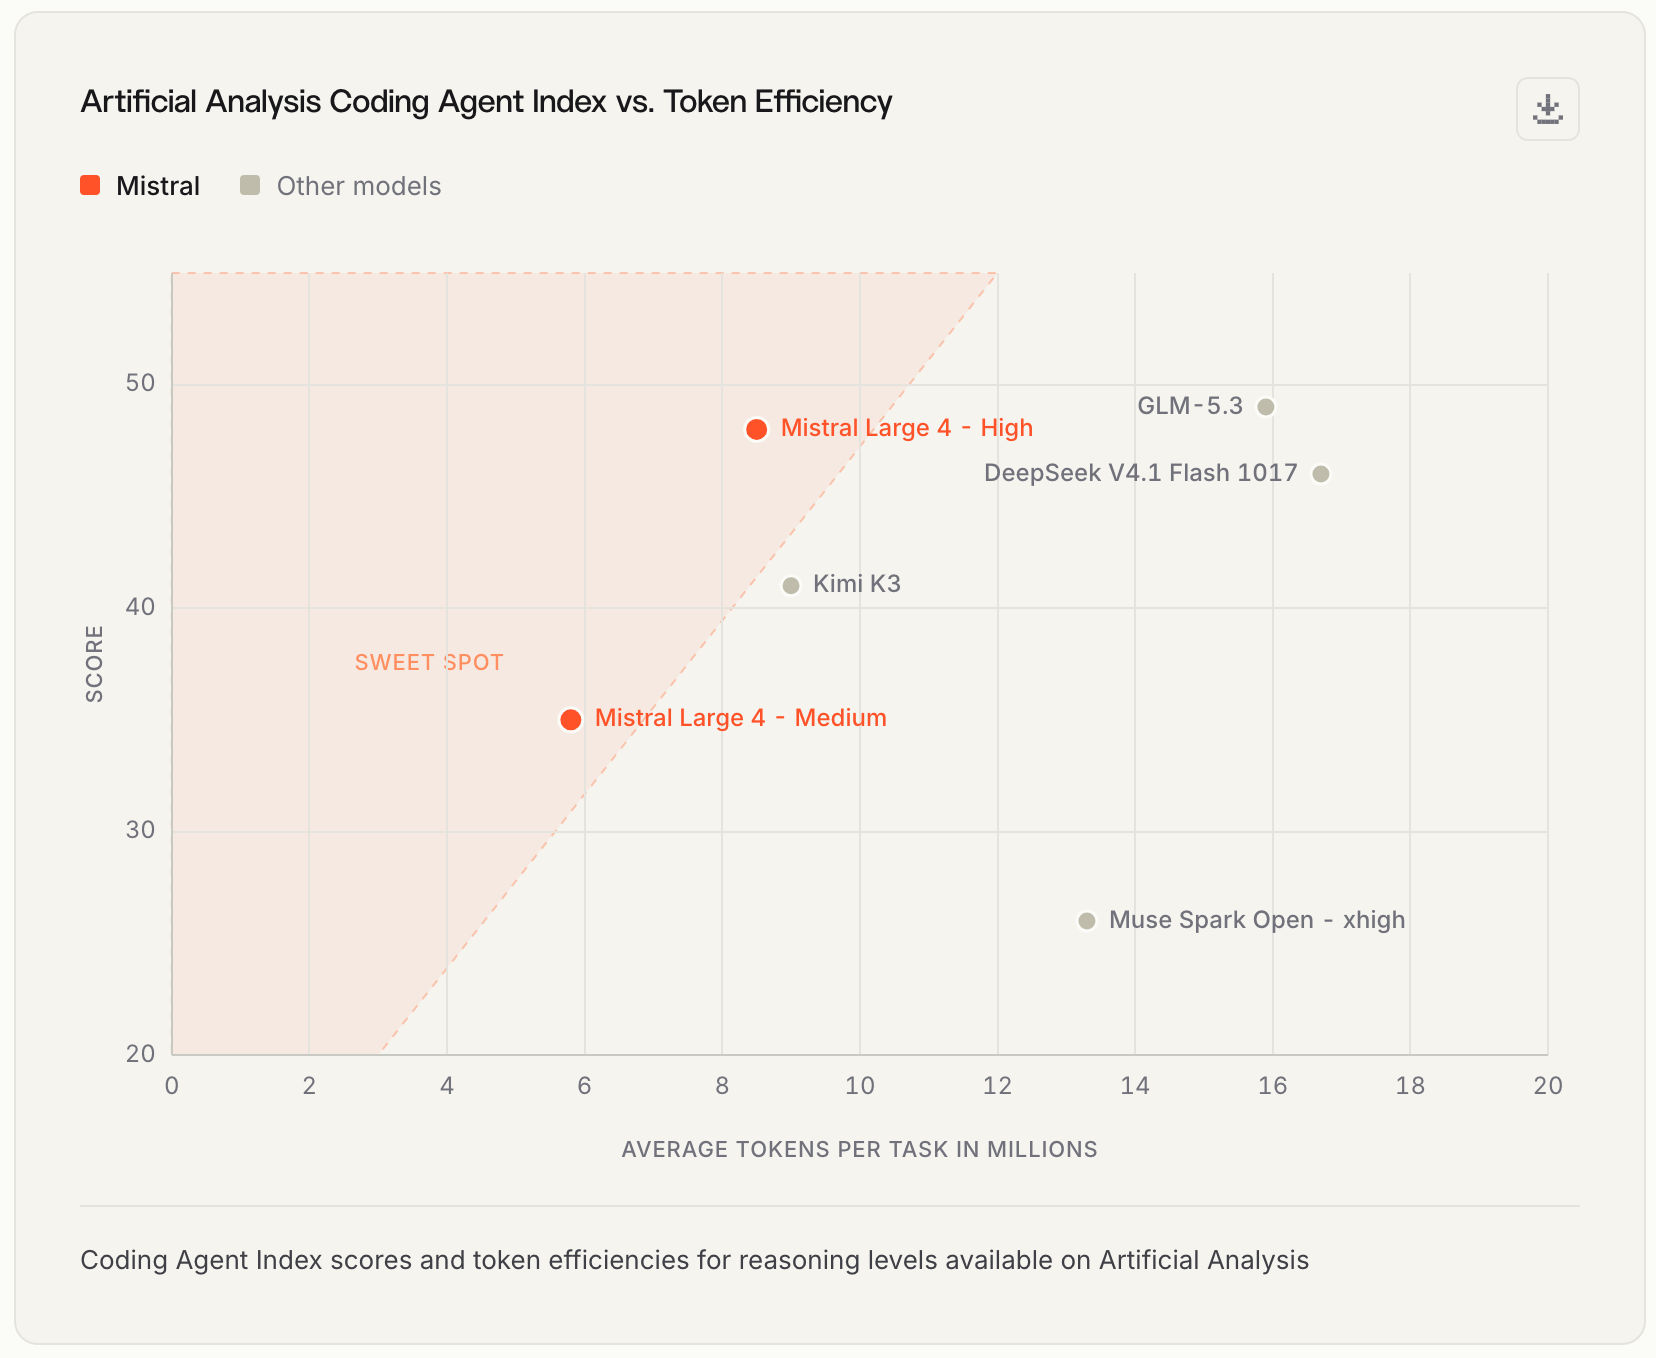 Mistral Large 4 Bench (Bild © Mistral)
Bereitstellung und API-Preise
Als Modell mit offenen Gewichten kann Mistral Large 4 selbst gehostet und an spezifische organisatorische Anforderungen angepasst werden. Für diejenigen, die einen Managed Service bevorzugen, bietet Mistral API-Zugriff. Die Preisstruktur liegt bei 70 Cent pro Million Eingabe-Tokens und 2,10 Euro pro Million Ausgabe-Tokens.
Hardwareanforderungen für lokales Hosting
Aufgrund der enormen Anzahl an Parametern erfordert die lokale Ausführung des Modells Hardware auf Rechenzentrumsniveau. Die Speicheranforderungen variieren je nach Quantisierungsstufe:
- 8-Bit-Quantisierung: Die Standardversion benötigt etwas mehr als 1 Terabyte Speicher, wofür in der Regel ein DGX-System mit acht H200-GPUs erforderlich ist.
- 4-Bit-Quantisierung (NVFP4): Diese Version benötigt etwa 610 Gigabyte Speicher. Dies lässt sich mit acht RTX Pro 6000-GPUs erreichen, einer Konfiguration, deren geschätzte Kosten 100.000 Euro übersteigen.
- 1-Bit-Quantisierung: Die von Unsloth bereitgestellten Versionen können auf zwei H200-GPUs ausgeführt werden, allerdings sinkt die Genauigkeit erheblich, wenn die Quantisierung unter 4 Bit fällt.
Benutzer müssen außerdem den zusätzlichen Speicherbedarf berücksichtigen, der für KV-Caches über die Gewichte des Basismodells hinaus erforderlich ist.