Computer Forum
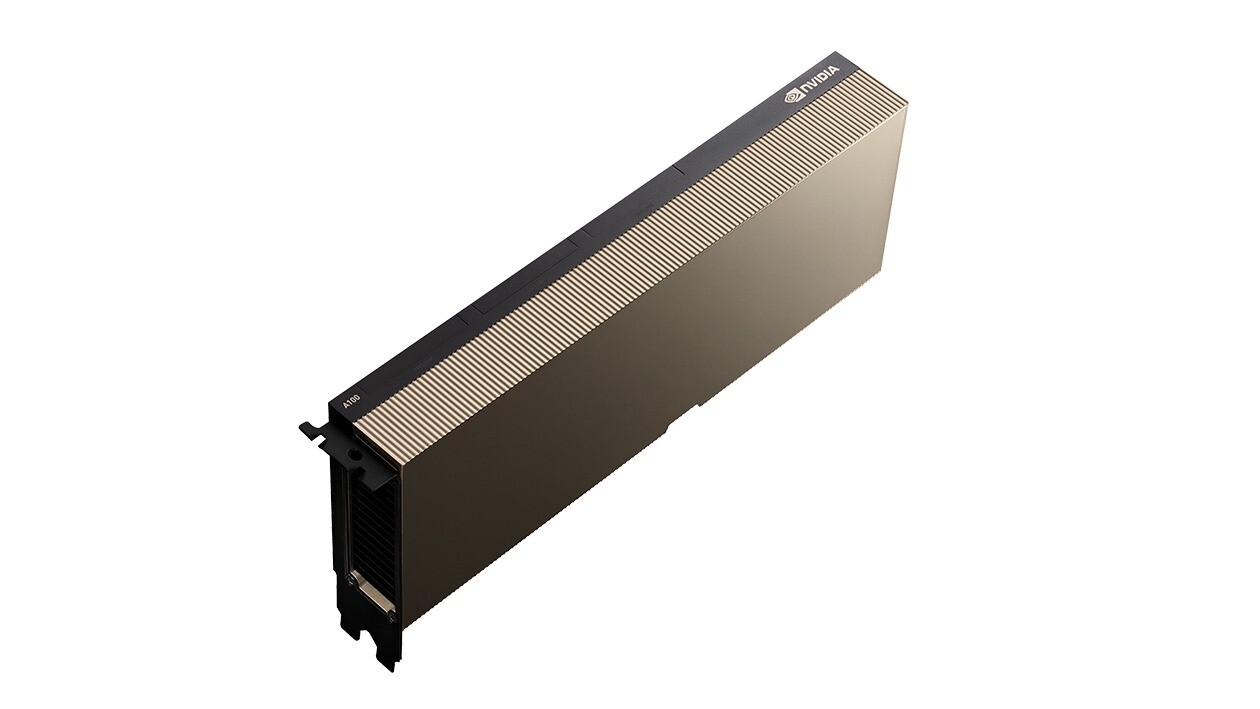 nvidia A100 (Bild © NVIDIA)
Für die Umsetzung sind Ubuntu 22.04 LTS oder Ubuntu 24.04 LTS sowie das Treiberpaket „NVIDIA Open GPU Kernel Modules“ aus dem 580.x-Zweig erforderlich. Aufgrund der hohen Wärmeabgabe der entsperrten Hardware und der passiven Kühlung durch die Kühlers, ist eine aktive Kühlung, insbesondere Lüfter mit mehr als 4.000 U/min in einem 4U-Rack-Gehäuse erforderlich, um eine thermische Abschaltung zu verhindern.
Der Unlock beginnt mit einer Systemprüfung, um das Vorhandensein der Geräte-IDs 10de:20c2 oder 10de:20b0 auf dem PCIe-Bus zu bestätigen. Hier der Befehl zur Prüfung:
lspci -nn | grep -i nvidia
Wichtige: Abhängigkeiten, darunter Python 3, der PyYAML-Parser und die „build-essential“-Tools, müssen installiert sein.
sudo apt update && sudo apt install -y build-essential python3 python3-pip python3-yaml git pciutils wget
Anschließend werden die Pakete „nvidia-driver-580-open“ und „nvidia-utils-580“ über das „graphics-drivers“-PPA installiert und als „hold“ markiert, um zu verhindern, dass automatische Updates die modifizierten Kernel-Module überschreiben.
sudo add-apt-repository ppa:graphics-drivers/ppa -y
sudo apt update
sudo apt install -y nvidia-driver-580-open nvidia-utils-580
Automatische Updates die Kernelmodule beschädigen:
sudo apt-mark hold nvidia-driver-580-open
Ein entscheidender Schritt in diesem Vorgang ist die Sicherung der ursprünglichen GSP-Firmware-Datei (GPU System Processor), „gsp_tu10x.bin“, bevor Änderungen vorgenommen werden. Anschließend wird das CMPUnlocker-Tool aus seinem Repository geklont, und es wird ein spezifisches Speicherprofil basierend auf der physischen Hardware-Revision ausgewählt, in der Regel das 8-GB-Profil für Karten, die 64 GB VRAM erreichen sollen.
Prüfen, ob GSP-Firmware vorhanden ist:
ls -la /lib/firmware/nvidia/580.*/gsp_tu10x.bin
Im Gegensatz zu Standard-Software-Updates erfordert diese Modifikation einen strengen Cold-Boot-Zyklus, um das WPR2-Register zurückzusetzen und den Zustand des SEC2-Kondensators zu löschen. Dazu muss das System ausgeschaltet und alle Stromkabel für mindestens 60 Sekunden abgezogen werden, um sicherzustellen, dass die gesamte Standby-Spannung aus den Kondensatoren des Mainboards und der GPU abgelassen wird.
Genauen Pfad des Treiberverzeichnisses erkennen:
GSP_DIR=$(dirname$(ls /lib/firmware/nvidia/580.*/gsp_tu10x.bin | head -n1))
Dann erstellen wir das Backup:
sudo cp "${GSP_DIR}/gsp_tu10x.bin" "${GSP_DIR}/gsp_tu10x.bin.stock"
echo "Backup gespeichert unter ${GSP_DIR}/gsp_tu10x.bin.stock"
Beim Neustart des Systems wird das Installationsskript ausgeführt, um die Patches anzuwenden. Da Registeränderungen flüchtig sind und einen Stromzyklus nicht überstehen, wird ein systemd-Daemon aktiviert, der die Register überwacht und den Patch beim Booten oder beim Neuladen von Treibern automatisch erneut anwendet.
Die abschließende Überprüfung erfolgt mit nvidia-smi, um die aktualisierte VRAM-Anzeige (z. B. 65.536 MiB) und die Aufhebung der SM-Taktfrequenzbeschränkungen zu bestätigen. Außerdem wird über ein Python-Skript ein CUDA-Initialisierungstest durchgeführt, um den vollen Rechendurchsatz sicherzustellen.
Repo lokale klonen:
cd /opt
sudo git clone [https://github.com/amoghmunikote/cmpunlocker.git](https://github.com/amoghmunikote/cmpunlocker.git)
cd cmpunlocker
Profileinstellungen prüfen:
sudo ./install.sh --profile=8gb
Im Falle von den selteneren 10-GB-Modellen wird die Freischaltung auf 40 GB oder gar 80 GB möglich sein, dafür brauchen wuir aber anderen Parameter:
sudo ./install.sh --profile=10gb)
Falls das System weiterhin nur 8 GB VRAM anzeigt, ist der Fehler in der Regel auf einen übersprungenen Kaltstart oder einen fehlerhaften GSP-Patch zurückzuführen. Thermische Drosselung oder PCIe-Bus-Ausfälle deuten auf einen unzureichenden Luftstrom hin. Wenn es bei hohen Arbeitslasten mit großen Sprachmodellen (LLM) zu Kernel-Abstürzen kommt, kann dies auf einen Siliziumfehler im HBM2e-Stack hindeuten, sodass der Nutzer die VRAM-Zuweisung über die Konfigurationsdateien auf 32 GB oder 40 GB reduzieren muss.
Dann noch CMPUnlocker als Hintergrunddienst starten und dafür sorgen, dass der Patch beim Start des Systgems samt Treiber automatisch geladen werden:
cd /opt/cmpunlocker
Als Root müssen wir die Install durchführen:
sudo ./install.sh
Status des systemd-Dienstes prüfen:
sudo systemctl status cmpunlocker.service
Schauen wir noch die Logs an, um die Wirkung des Patches zu prüfen:
journalctl -u cmpunlocker -f -n 20
Zuletzt wollen wir noch prüfen, ob der Speicher und Recheneinheiten auch vorhanden sind, indem wir nvidia-smi abfragen und einen kurzen CUDA-Test durchführen:
nvidia-smi --query-gpu=name,memory.total,clocks.max.sm --format=csv
Wir wollen hier eine passende GPU mit ca 65.536 MB VRAM und etwa 1.410 MHz sehen.
Häufig gestellte Fragen (FAQ)
Was ist der Hauptzweck der Verwendung von CMPUnlocker auf dem CMP 170HX?
Das Tool dient dazu, werkseitig festgelegte Beschränkungen zu umgehen, die bestimmte Streaming-Multiprozessoren deaktivieren und den zugänglichen HBM2e-Speicher begrenzen. Dadurch kann der Nutzer das volle Rechenpotenzial der GPU wiederherstellen und die VRAM-Kapazität erweitern – oft von 8 GB auf bis zu 64 GB.
Warum sind ein Kaltstart und das Trennen der Stromversorgung zwingend erforderlich?
Ein normaler Neustart reicht nicht aus, da das WPR2-Register und die SEC2-Kondensatoren vollständig entladen werden müssen, damit die Unlock-Patches wirksam werden können. Das Trennen der Stromversorgung für 60 Sekunden stellt sicher, dass die Hardware in einen Zustand zurückgesetzt wird, in dem die Register überschrieben werden können.
Welche spezifischen Treiber sind erforderlich, damit dieser Vorgang funktioniert?
Der Vorgang hängt von den NVIDIA Open GPU Kernel Modules ab, insbesondere vom 580.x-Treibenzweig. Das liegt daran, dass der Unlocker auf bestimmte Register-Überschreibungen innerhalb der GSP-Firmware angewiesen ist, die von diesen Open-Source-Treibern geladen wird.
Welche thermischen Risiken sind mit dieser Modifikation verbunden?
Da der Vorgang deaktivierte Hardwarekomponenten wiederherstellt, erzeugt die GPU deutlich mehr Wärme. Passive Kühlung reicht nicht aus; es sind Lüfter mit hohem statischen Druck (4.000+ U/min) erforderlich, um zu verhindern, dass die Karte eine thermische Abschaltung auslöst.
Was ist zu tun, wenn das System nach dem Freischalten unter hoher KI-Auslastung abstürzt?
Abstürze unter hoher Last deuten oft auf einen Hardwarefehler in einem der neu freigeschalteten Speicherstapel hin. In solchen Fällen sollte der Nutzer die Datei „constants.yaml“ anpassen oder das Installationsskript mit einem niedrigeren Profil (z. B. 40 GB) ausführen, um den VRAM auf eine stabilere Kapazität zu begrenzen.
Wie lässt sich der Erfolg der Freischaltung überprüfen?
Der Erfolg wird über den Befehl „nvidia-smi“ überprüft, der die Gesamtgröße des erweiterten Speichers (z. B. 65.536 MiB) und die maximale SM-Taktfrequenz anzeigen sollte. Zusätzlich kann ein CUDA-Initialisierungsskript bestätigen, dass die GPU ordnungsgemäß funktioniert.