 Computer Forum
 Ollama lokale Text to Speech (Bild © Ollama)
lokale Text-to-Speech konfigurieren
Um die Sprachfunktionen nutzen zu können, musst du zunächst Ollama v0.40.9 oder eine neuere Version installieren und das Phonon-Modell mit dem folgenden Befehl herunterladen:
ollama pull phonon
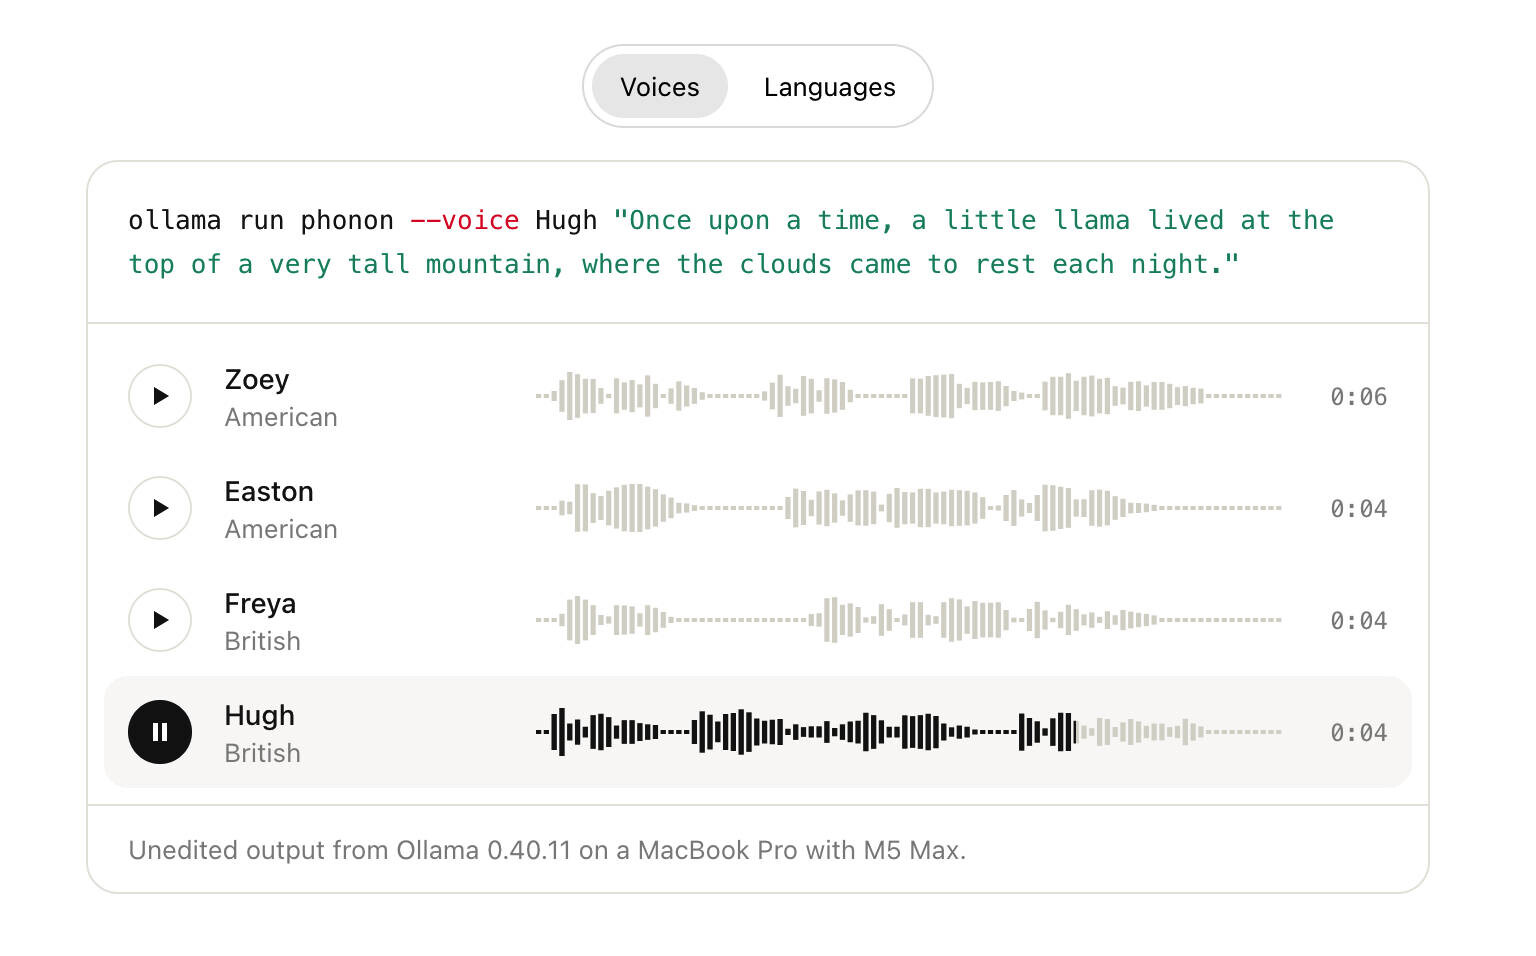
Das Phonon-Modell enthält mehrere vorkonfigurierte englische Stimmen, insbesondere Zoey, Easton und Freya. Wenn keine bestimmte Stimme ausgewählt wird, verwendet das System standardmäßig die native Stimme des Checkpoints. Benutzer können eine vollständige Liste der verfügbaren Stimmen anzeigen, indem sie ollama show phonon ausführen. Das System ist so konzipiert, dass es bei der Eingabe von Stimmennamen flexibel ist und verschiedene Groß- und Kleinschreibungen sowie Formate akzeptiert.
 Ollama lokale Text to Speech Sprachen (Bild © Ollama)
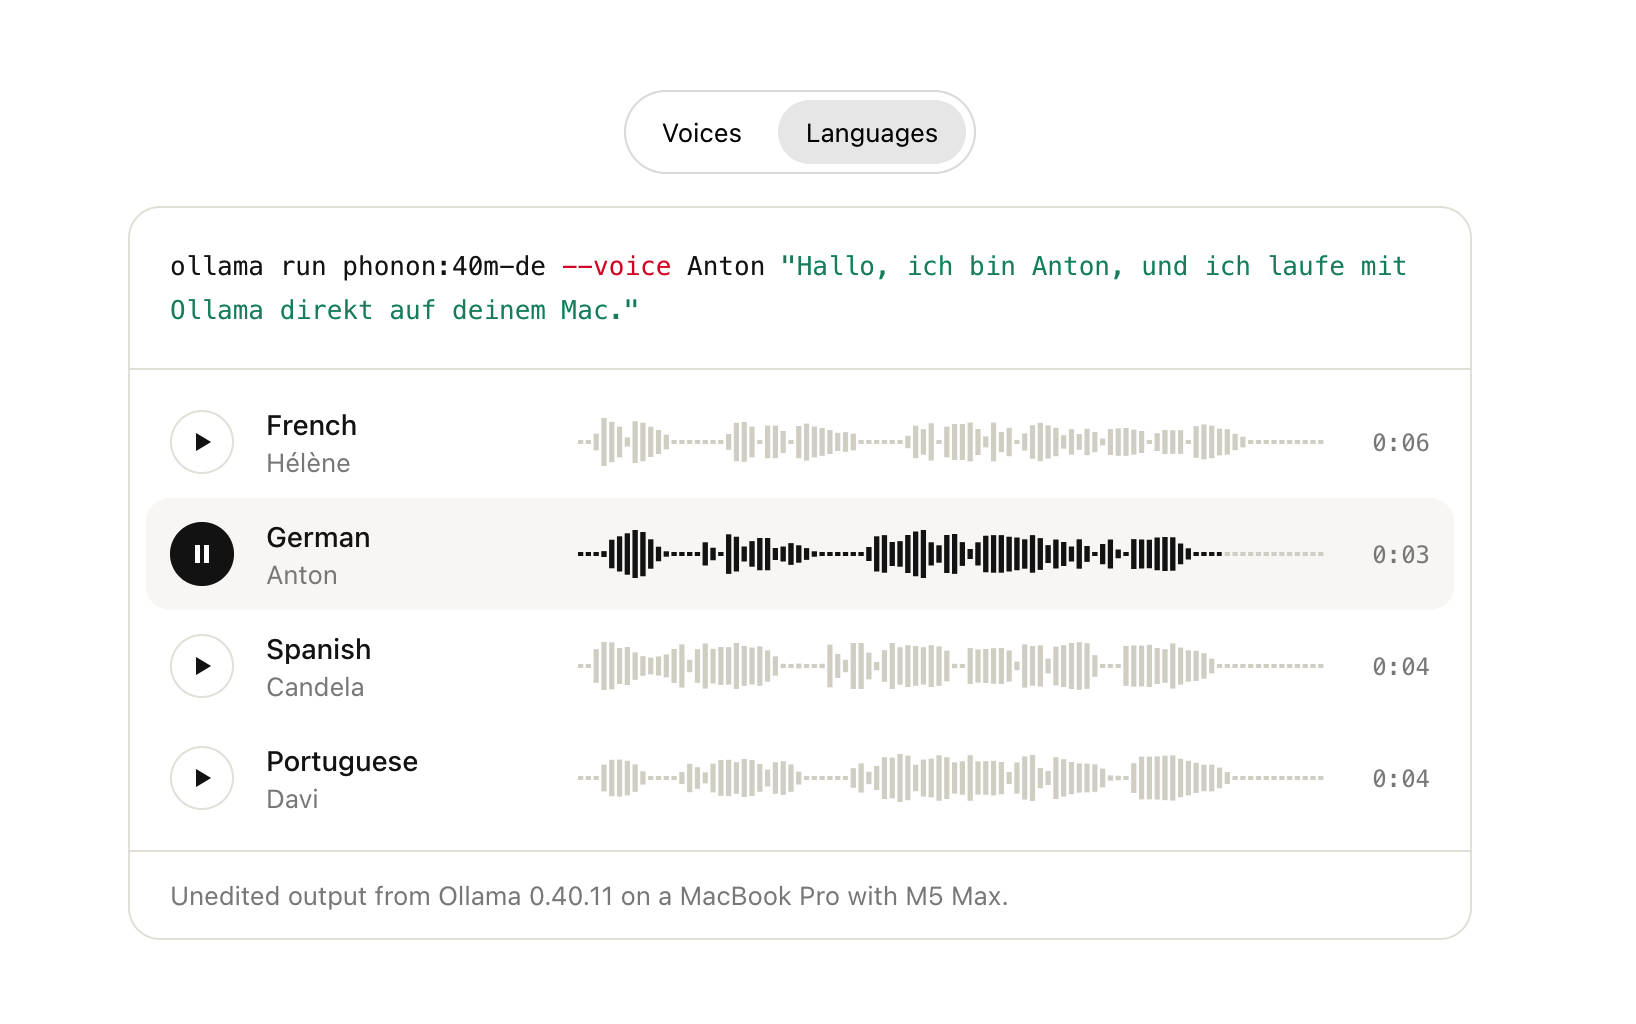
Phonon Sprachen
- phonon: Englisch
- phonon:40m-fr: Französisch
- phonon:40m-de: Deutsch
- phonon:40m-es: Spanisch
- phonon:40m-pt: Portugisisch
- phonon:40m-multilingual: Alle fünf Sprachen
Terminalbedienung und Audio-Streaming
Die Audiogenerierung ist direkt in die Befehlszeilenschnittstelle integriert. Mit
ollama run
streamt das System Audio in Echtzeit über die Hardware-Lautsprecher des Computers, was bedeutet, dass die Wiedergabe beginnt, bevor die gesamte Textzeichenfolge vollständig verarbeitet wurde.
Zu den gängigen Terminalbefehlen gehören:
Grundlegende Sprachausgabe:
ollama run phonon „Zu sprechender Text“
Sprachauswahl:
ollama run phonon --voice Zoey „Zu sprechender Text“
Externe Eingabe: Text aus anderen Programmen direkt in das Modell einspeisen.
LLM-Integration:
Die Ausgabe eines Chat-Modells, wie z. B. gemma4, in Phonon einspeisen, um eine sprachgestützte KI-Antwort zu erstellen. Zum Beispiel:
ollama run gemma4 --hidethinking „Eingabeaufforderung“ | ollama run phonon
Für die interaktive Nutzung öffnet der Befehl ollama run phonon ohne Argumente eine Eingabeaufforderung, bei der jede Textzeile beim Drücken der Eingabetaste vorgelesen wird. Das System nutzt native Betriebssystem-Player für die Ausgabe: afplay unter macOS, PowerShell unter Windows und eine Prioritätenliste aus paplay, pw-play, aplay oder ffplay unter Linux.
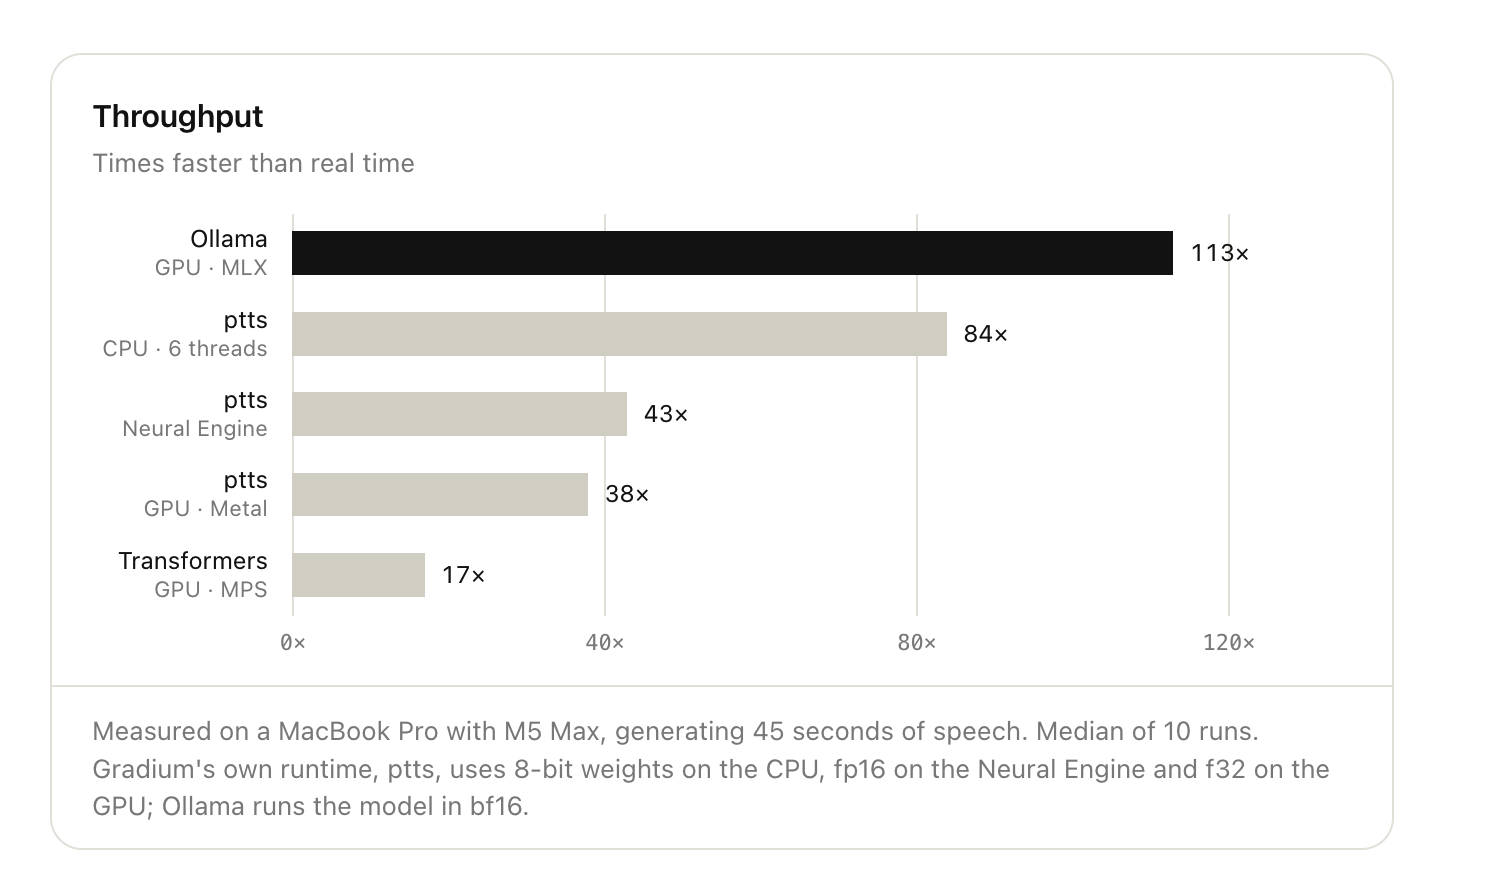 Ollama lokale Text to Speech Durchsatz (Bild © Ollama)
Dateiexport und Konfiguration des Remote-Servers
Das System unterstützt die Umleitung der Audioausgabe, um die Sprachausgabe als Datei zu speichern. Wenn die Ausgabe umgeleitet wird, erzeugt die Software eine WAV-Datei, anstatt den Ton über Lautsprecher abzuspielen:
ollama run phonon „Text“ > output.wav
In Umgebungen, in denen die Ollama-Instanz auf einem Remote-Server ohne Audio-Hardware gehostet wird, kannst du den Befehl auf einem lokalen Rechner ausführen und ihn mithilfe der OLLAMA_HOST-Umgebungsvariable auf den Server verweisen:
OLLAMA_HOST=server-ip:11434 ollama run phonon "Text"
API-Integration und technische Spezifikationen
Ollama stellt einen OpenAI-kompatiblen API-Endpunkt unter /v1/audio/speech für die programmgesteuerte Sprachgenerierung bereit. Dieser Endpunkt unterstützt Streaming-Antworten, sodass Entwickler die Audiowiedergabe starten können, während der Rest der Datei noch generiert wird.
Audio-Ausgabeformate
Die API unterstützt zwei primäre Antwortformate:
- **WAV (Standard): 16 Bit, Mono, 24 kHz. Aufgrund des Streaming-Charakters der Generierung werden die Größenfelder im WAV-Header auf den Maximalwert gesetzt.
- **PCM: Rohe 16-Bit-Little-Endian-Samples, Mono, 24 kHz, ohne Header.
Anforderungsbeschränkungen und Datenverarbeitung
Für die Eingabe gelten bestimmte technische Beschränkungen und Vorverarbeitungsregeln:
-
Zeichenbegrenzung: Jede Anfrage ist auf 4.096 Zeichen begrenzt. Der Befehl
ollama runverwaltet längere Texte automatisch, indem er sie an Satz- und Absatzgrenzen aufteilt. - Textnormalisierung: Das Modell wandelt Symbole, Preise und Zahlen automatisch in gesprochene Wörter um. Währungssymbole werden beispielsweise zu vollständigen Wörtern erweitert (z. B. „Dollar“ und „Cent“).
- Formatierung: Um eine natürliche Vorlesung zu gewährleisten, sollten Datumsangaben ausgeschrieben werden (z. B. „23. Oktober“) statt numerischer Kurzformen zu verwenden. Das System ist so programmiert, dass es Markdown-Marker, Aufzählungszeichen und Emojis ignoriert.
- Fehlerbehandlung: Anfragen, die nicht unterstützte Optionen enthalten, wie z. B. benutzerdefinierte Sprechgeschwindigkeiten oder Anweisungen, lösen einen 400-Fehler aus. Ebenso führt die Anforderung einer unbekannten Stimme zu einem 400-Fehler, der eine Liste gültiger Sprachoptionen enthält.
- Modellumfang: Phonon ist ein spezielles Sprachmodell. Alle Anfragen für Chat, Vervollständigungen oder Einbettungen, die an dieses Modell gesendet werden, führen zu einem 400-Fehler.