 Computer Forum
Künstliche Intelligenz (KI)
Linux
News
Tech-Guide & Tipps
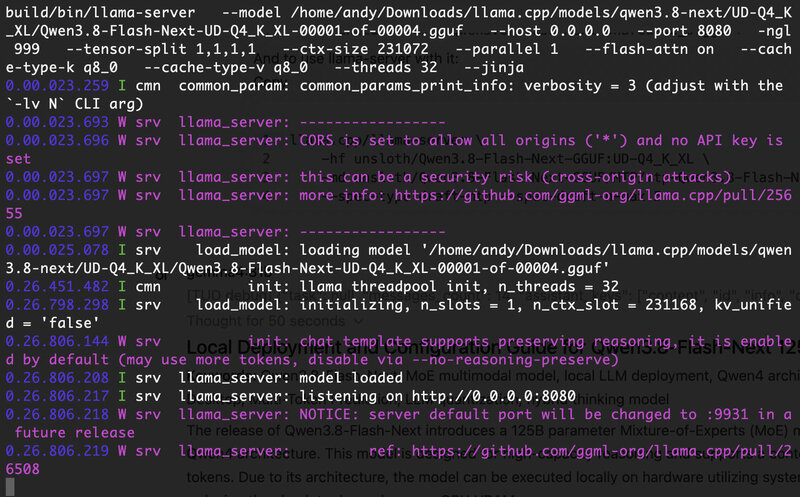
Qwen3.8-Flash-Next 125B-MoE-Modell lokalen betreiben mit Konfigurationsoptionen
Mit der Veröffentlichung von Qwen3.8-Flash-Next wird ein multimodales „Mixture-of-Experts“ (MoE)-Modell mit 125 Milliarden Parametern eingeführt, das auf der Qwen4-Architektur basiert. Dieses Modell ist für Reasoning ausgelegt und unterstützt ein Kontextfenster von bis zu 262.144 Tokens. Dank seiner Architektur kann das Modell lokal auf Hardware ausgeführt werden, die System-RAM oder Unified Memory nutzt, wodurch die absolute Abhängigkeit vom GPU-VRAM reduziert wird.
Guide