 Computer Forum
 NVIDIA RTX Spark DGX Spark und DGX Station (Bild © NVIDIA)
RTX Spark: Lokale Intelligenz für Windows
Der RTX Spark ist als Hochleistungssystem für Windows-Umgebungen fungieren, bietet aber auch vollen Support für Linux, was für KI einfach die bessere Option ist. Mit dem System sollen persönliche KI-Agenten und die beschleunigte Erstellung von Inhalte als Gesamtpaket geliefert werden. Das System bietet bis zu 128 GB einheitlichen Speicher und liefert 1 Petaflop an KI-Rechenleistung. Das deckt sich in etwa mit den Ryzen AI Max+ PRO 495 decken, die jedoch sogar 192 GB Unified Memory bieten. Neben KI-Aufgaben unterstützt das System angeblich auch Gaming mit einer Auflösung von 1440p bei 100 fps, aber den abgerufenen Preis zahlen Gamer niemals für so ein System.
Eine Software-Ergänzung ist der Underdog-Desktop-Agent, der die modellspezifische Inferenz-Engine „Husky“ nutzt, um KI-Modelle vollständig auf dem Gerät auszuführen. Diese Architektur stellt sicher, dass Benutzerdaten lokal verbleiben und die Hardware nicht verlassen. Um Anpassungen und die Entwicklung von Agenten zu unterstützen, werden mehrere RTX-Spark-Laptop-Modelle mit entsperrten Bootloadern ausgeliefert. Die Hardware ist über Partner wie ASUS, Dell Technologies, HP, Lenovo, Microsoft und MSI erhältlich.
DGX Spark: Skalierbare Entwicklung für Linux
Der DGX Spark ist für Entwickler konzipiert und die meisten sitzen nicht auf Windows, wenn da die Tools in Linux umfangreicher sind. Eine neue 64-GB-Konfiguration soll am 23. Oktober auf den Markt kommen und unterstützt Modelle wie Nemotron 3.5 Bolt 74B, Qwen 3.8 27B und Gemma 4. Es gibt aber in dem Segment noch viel mehr Optionen.
Für Workloads, die die Kapazität einer einzelnen Einheit überschreiten, unterstützt das System Clustering über NVIDIA ConnectX-7-Netzwerktechnologie und den NVIDIA Sync Cluster Assistant. Bei einer manuellen Konfiguration können bis zu acht DGX Spark-Einheiten zu einem Cluster mit 1 TB einheitlichem Speicher verbunden werden. Diese Konfiguration ermöglicht die Ausführung größerer Modelle wie GLM 5.3 und erlaubt es mehreren Entwicklern, parallele Sitzungen auf einem gemeinsamen Backend auszuführen.
Zu den kommenden Software-Updates gehören der NVIDIA Sync Model Launcher, der das Herunterladen von Modellen und Containern automatisiert, sowie ein Wi-Fi-Assistent zur Verwaltung von Netzwerken im Appliance-Modus. DGX Spark-Systeme sind über verschiedene Partner erhältlich, darunter GIGABYTE, Acer, ASUS und andere.
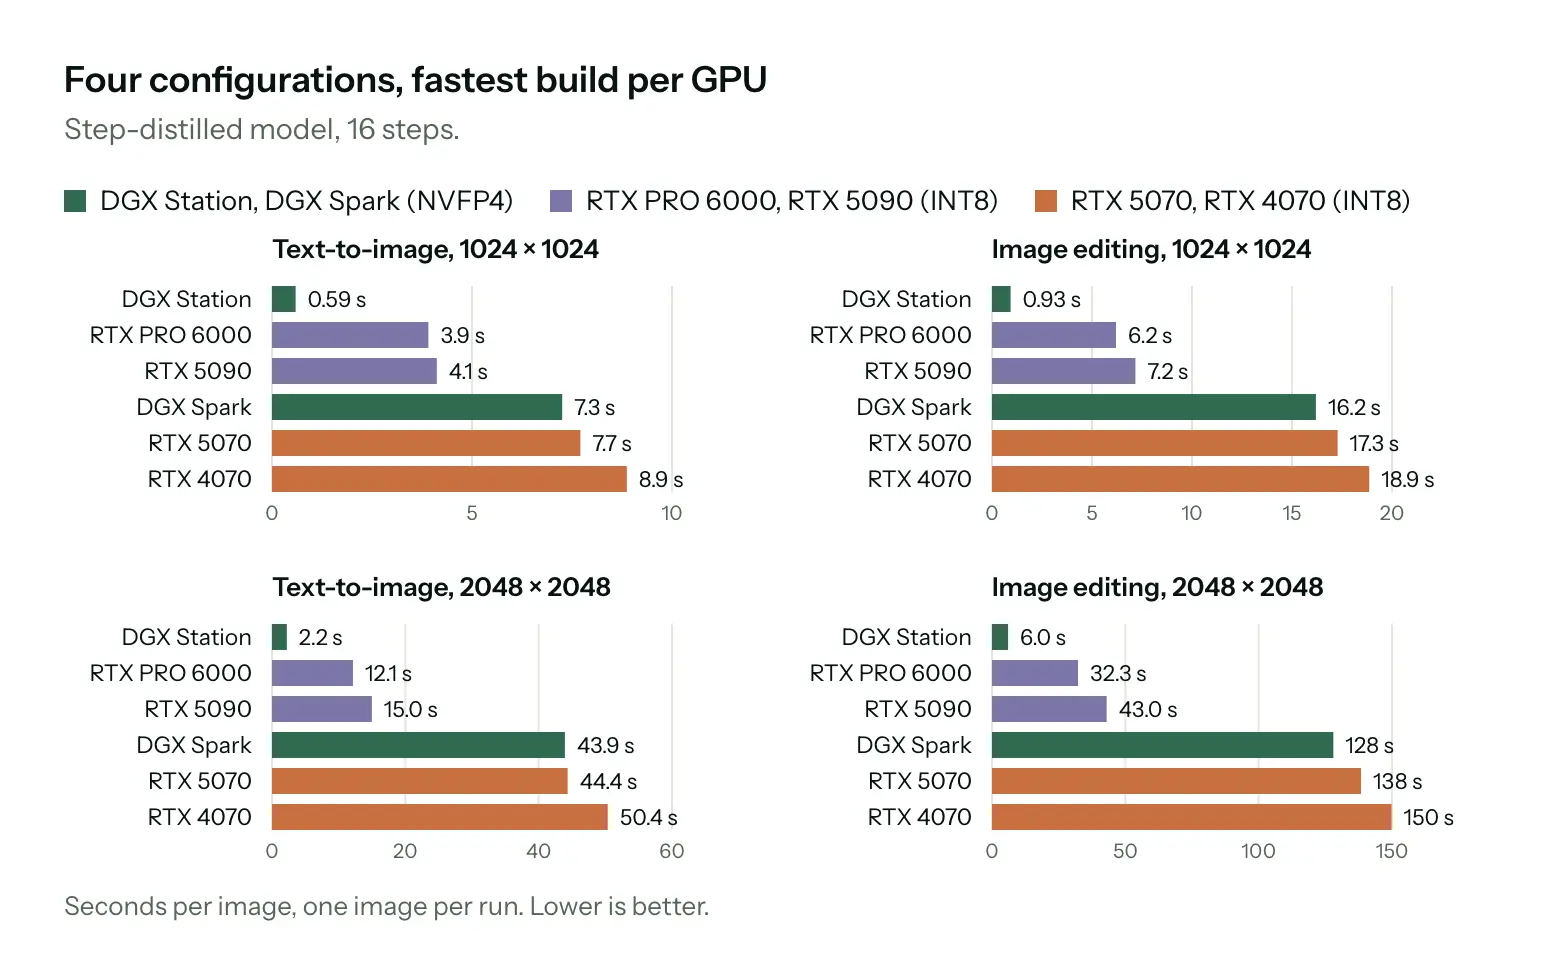 NVIDIA RTX Spark DGX Spark und DGX Station Benchmarks (Bild © NVIDIA)
DGX Station: Lokale Inferenz auf Unternehmensniveau
Für größere Unternehmen mit tiefen Taschen soll die DGX Station mit 748 GB kohärenten Speicher auf den Markt kommen und bis zu 20 Petaflops KI-Leistung. Damit kann das System über 30 Nutzer mit Geschwindigkeiten bedienen, die mit cloudbasierten Modellen vergleichbar sind. Genaue Spezifikationen kommen erst noch und es ist davon auszugehen, dass es auch hier mehrere Varianten geben wird.
Unternehmensverwaltung und Windows-Integration
Um die Bereitstellung in Unternehmensumgebungen zu vereinfachen, hat NVIDIA sieben neue Integrationen für das IT-Management eingeführt, darunter Splunk von Cisco, Microsoft Intune, Absolute Security und Tanium. Eine Windows-basierte Version der DGX Station wird für Dezember erwartet. Diese Version ermöglicht es Ingenieuren, lokale LLMs auf NVIDIA GB300-Systemen auszuführen und dabei Windows-native Software zu nutzen. Zu den unterstützten Anwendungen für Fertigung und Ingenieurwesen gehören solche von Siemens, Dassault Systèmes, MathWorks und Rockwell Automation.
Robotik und Cloud Functions
Die DGX Station dient als dedizierter Rechenknoten für die Robotik und stellt Ressourcen für die Nachbearbeitung nach dem Training sowie für Simulationen bereit. NVIDIA hat drei Open-Source-Referenz-Workflows veröffentlicht, die GPT-6 Astra und Isaac Lab nutzen, um GR00T 1.7-Modelle zu verfeinern und die Generierung synthetischer Daten über Cosmos-Weltmodelle zu trainieren. Darüber hinaus wird NVIDIA Cloud Functions für Linux-basierte DGX-Station-Systeme im Early-Access-Modus verfügbar sein. Diese Funktion ermöglicht es Teams, lokale Modell-Endpunkte in einem gemeinsamen Katalog zu registrieren, auf den über einen einzigen OpenAI-kompatiblen Einstiegspunkt zugegriffen werden kann, wodurch die Station zu einem lokal gesteuerten Inferenzdienst wird.
Recursive Flint und das lokale Modell-Ökosystem
Das Pionier-KI-Labor Recursive Superintelligence hat „Recursive Flint“ veröffentlicht, ein für RTX Spark optimiertes lokales LLM (Large Language Model). Das Modell nutzt eine „Mixture-of-Experts“-Architektur mit insgesamt 40 Milliarden Parametern und 2,5 Milliarden aktiven Parametern. Auf einem RTX Spark mit 64 GB erreicht es Inferenzgeschwindigkeiten von über 220 Tokens pro Sekunde. Das Modell ist unter der Apache-2.0-Lizenz auf Hugging Face verfügbar.
Day-Zero-Modellunterstützung
NVIDIA hat „Day-Zero“-Unterstützung für mehrere neue Modelle implementiert:
- Nemotron Bolt E4B: Ein 4-GB-Modell für lokale Sprachassistenten und eingebettete Schnittstellen, das am 23. Oktober veröffentlicht wird.
- FLUX.3 Image Small: Ein Bildgenerierungsmodell mit 5,6 Milliarden Parametern, das auf GeForce RTX-GPUs mit 8 GB VRAM ausgeführt werden kann.
- Liquid AI LFM2.5-24B-A2B: Ein Schlussfolgerungsmodell, das pro Token nur 2 Milliarden Parameter aktiviert.
- MiniMax M3.1 Flash: Ein offenes Modell, das für KI mit langen Kontexten auf DGX Station und DGX Spark entwickelt wurde.
Um diese Modelle für lokale Hardware zu optimieren, hat NVIDIA eine Sammlung quantisierter Checkpoints veröffentlicht, darunter Qwen 3.8-Flash-Next-FP4-Local, um eine effiziente RAM-Nutzung bei gleichbleibender Genauigkeit zu gewährleisten.
Optimierungen der Inferenz-Engine
NVIDIA hat mit den vLLM- und llama.cpp-Communities zusammengearbeitet, um die Leistung agentischer Workloads auf lokaler Hardware zu verbessern:
- llama.cpp: Die Integration spekulativer Dekodierung mit MTP für Qwen 3.8 Flash Next erhöht die Geschwindigkeit auf der NVIDIA RTX PRO 6000 Blackwell um bis zu das 1,4-Fache.
- vLLM: Neue „FlashInfer“-Prefill-Kernel und eine verbesserte spekulative Dekodierung steigern die Geschwindigkeit für Qwen 3.8 27B auf der DGX Spark um das 1,3-Fache und erhöhen den Durchsatz für GLM 5.3 Flash auf der DGX Station um das 1,2-Fache.
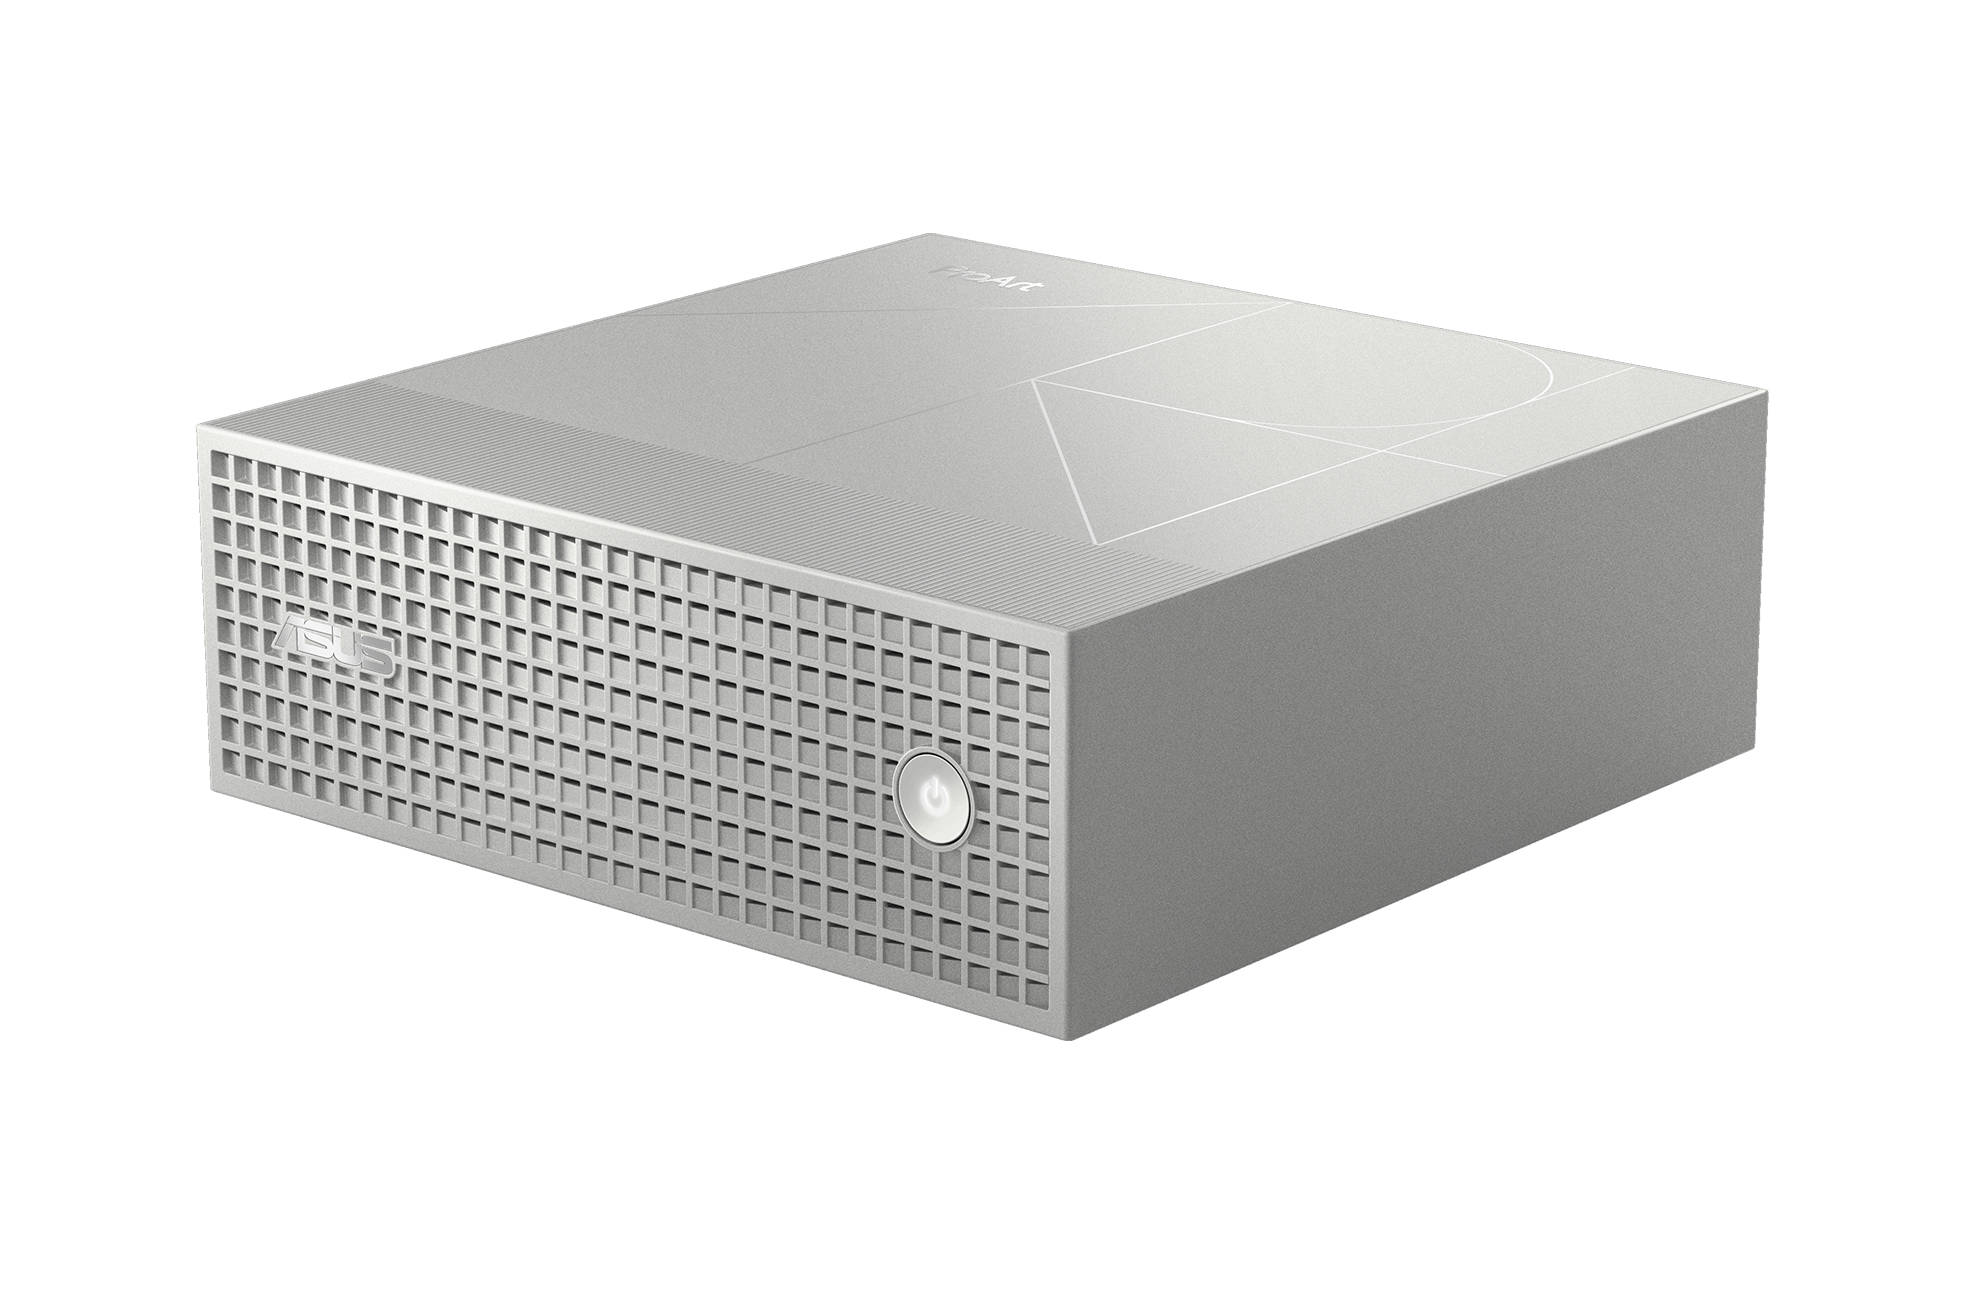 ASUS ProArt GR1X Mini PC Silber (Bild © ASUS)
An diesen Beispielen sieht man, dass NVIDIA nicht nur die großen Rechenzentren bedienen will, sondern auch lokale Modelle in der EU pushen will, um AMD zuvor zu kommen. In den letzten Jahren hat NVIDIA den Fokus klar auf USA gehabt, doch durch den derzeitigen Shift wird EU endlich unabhängiger und muss eigene Strukturen aufbauen, was NVIDIA wiederum für sich nutzen will. Die Preise werden noch spannend, denn es gibt bisher nur die DGX Station von Partnern, zu denen wir bereits einiges geschrieben haben: