 Computer Forum
 Qwen3 8 Flash Next 125B MoE Modell (Bild © PCMasters.de)
Hardwareanforderungen und Speicherzuweisung
Der Betrieb von Qwen3.8-Flash-Next erfordert erhebliche Speicherkapazität. Die Mindestanforderung für die kleinste quantisierte Version beträgt 75 GB RAM oder Unified Memory. Für optimale Stabilität werden Geräte mit 96 GB Speicher empfohlen.
Der Speicherbedarf variiert je nach verwendetem Quantisierungsgrad. Quantisierungsgrad und Gesamter Speicherbedarf (RAM + VRAM / Unified):
- 1-Bit: 75 GB
- 2-Bit: 79 GB
- 3-Bit: 90 GB
- 4-Bit: 96–114 GB
- 5-Bit: 163 GB
- 8-Bit: 200 GB
- BF16: 355 GB
Die 1-Bit-quantisierte Version ist etwa 79 % kleiner als das BF16-Original (355 GB) und behält dabei eine Genauigkeitsrate von 80 % im obersten 1 % bei. Dies wird durch den Einsatz von „Per Layer Embeddings“ (PLE) und Ngrams erreicht, die als Nachschlagetabellen fungieren. Im Gegensatz zu anderen Schichten werden diese Ngram-Komponenten auf einer Quantisierungsstufe von mindestens 4 Bit gehalten, um eine erhebliche Verschlechterung der Modellgenauigkeit zu verhindern.
Ausführungsframeworks und Installation
Das Modell lässt sich über zwei Hauptwege bereitstellen: Unsloth Desktop und llama.cpp.
Bereitstellung über Unsloth Desktop
Unsloth Desktop bietet eine plattformübergreifende Oberfläche für macOS, Windows und Linux. Es verfügt über automatisches Speicher-Offloading und Multi-GPU-Erkennung. Über einfache Inferenz hinaus unterstützt dieses Framework:
- Aufruf von Selbstheilungs-Tools und integrierte Websuche.
- Lokale Ausführung von Python- und Bash-Code.
- Automatische Optimierung der Inferenzparameter.
- Integration mit externen Tools wie Claude Code und MCP.
Die Installation kann über die offizielle Desktop-Anwendung oder über die Befehlszeile mit curl für Unix-basierte Systeme und PowerShell für Windows erfolgen.
Bereitstellung mit llama.cpp
Für Nutzer, die eine Implementierung auf niedrigerer Ebene bevorzugen, ist das Modell im GGUF-Format verfügbar. Für den Einsatz ist die neueste Version von llama.cpp erforderlich, die mit CUDA-Unterstützung für NVIDIA-GPUs oder Metal-Unterstützung für Apple Silicon kompiliert wurde. Der Vorgang umfasst das Herunterladen der GGUF-Dateien von Hugging Face oder ModelScope und deren Ausführung über die Binärdateien llama-cli oder llama-server.
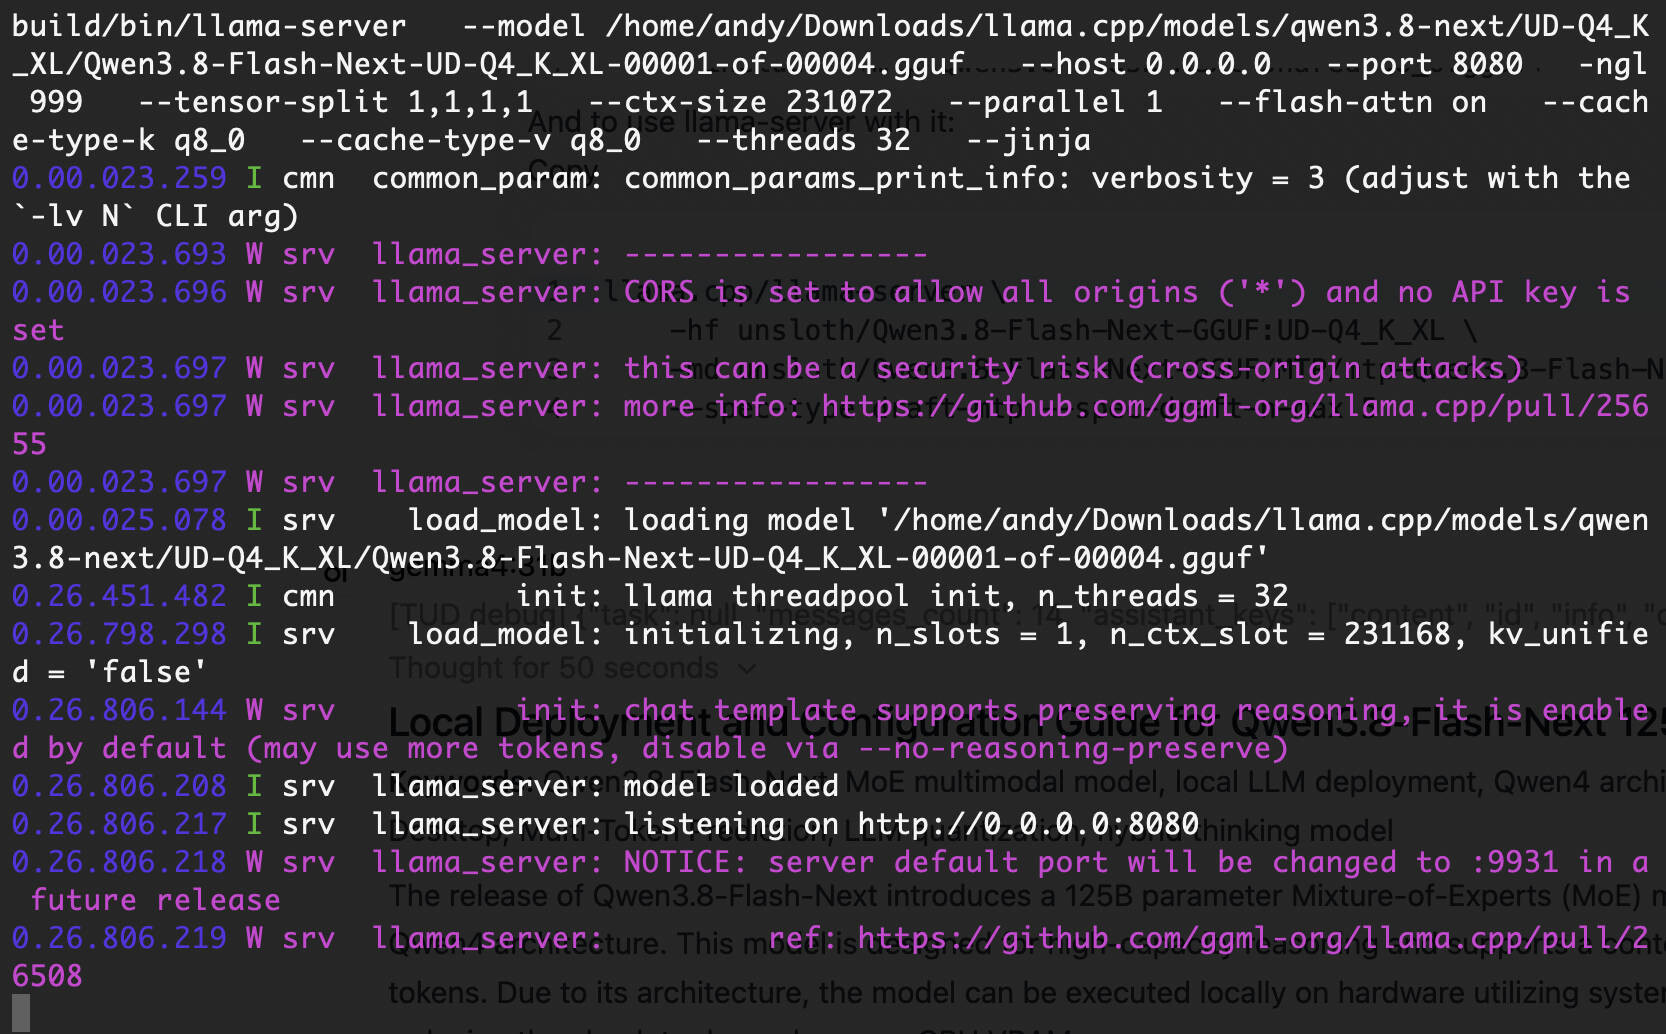
Hier das Beispiel, wie wir das Deployment ausführen mit den vier TESLA V100 32 GB Beschleunigern:
CUDA_VISIBLE_DEVICES=0,1,2,3 /home/andy/Downloads/llama.cpp/build/bin/llama-server --model /home/andy/Downloads/llama.cpp/models/qwen3.8-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf --host 0.0.0.0 --port 8080 -ngl 999 --tensor-split 1,1,1,1 --ctx-size 231072 --parallel 1 --flash-attn on --cache-type-k q8_0 --cache-type-v q8_0 --threads 32 --jinja
-
CUDA_VISIBLE_DEVICES=0,1,2,3: Es werden die vier Karten alle dafür verwendet -
--cache-type-k q8_0: Es wird ein Q8-KV-Cache verwendet -
--tensor-split 1,1,1,1: Das Modell wird auf allen vier Karten gleich verteilt, auf allen vier Karten wird die Last auch so verteilt -
--host 0.0.0.0: Lokal für das Netzwerk zugänglich auf der lokalen IP des Servers -
--port 8080: Der Port 8080 wird noch exposed -
--ctx-size 231072: Der Context im KV-Cache wird bei 230k Token gesetzt
Leistungsoptimierung durch Multi-Token-Prediction (MTP)
Um die Inferenzgeschwindigkeit zu erhöhen, unterstützt Qwen3.8-Flash-Next die Multi-Token-Prädiktion (MTP). Diese Technologie ermöglicht es dem Modell, mehrere Token gleichzeitig statt nacheinander vorherzusagen, was zu einer Geschwindigkeitssteigerung um das 1,3- bis 1,7-Fache führt. Auf einer einzelnen RTX 6000 PRO-GPU kann MTP den Durchsatz von einem Basiswert von 100 Token/s auf 170 Token/s steigern.
Auf unseren vier TESLA V100 erreichen wir gemischte Werte, die von 300 bis 700 Token/s liegen. Das reichte uns insgesamt für Coding-Aufgaben aus.
Die MTP-Implementierung erfordert zusätzlichen Speicherplatz von 1 bis 2 GB. Um diesen Overhead zu reduzieren, stehen gemeinsam genutzte MTP-Module zur Verfügung, die die eingebetteten Tokens ausschließen und sie mit dem Hauptmodell teilen.
MTP-Speicher-Overhead nach Quantisierung:
- BF16: Allgemeines MTP (7,77 GB) vs. gemeinsam genutztes MTP (5,23 GB)
- Q8_0: Allgemeines MTP (4,14 GB) vs. Geteiltes MTP (2,79 GB)
- Q4_K_M: Allgemeines MTP (2,79 GB) vs. Geteiltes MTP (1,91 GB)
Betriebsparameter und Denkmodi
Qwen3.8-Flash-Next ist ein hybrides Denkmodell, was bedeutet, dass es je nachdem, ob es sich im Denkmodus oder im Befehlsmodus (Nicht-Denkmodus) befindet, mit unterschiedlichen Einstellungen arbeitet. Parameter / Denkmodus / Befehlsmodus
Außerdem unterstützt das Modell einen reasoning_effort-Parameter zur Steuerung der Analysetiefe:
- xhigh (Standard): Für komplexe Aufgaben, die eine umfassende Analyse erfordern.
- medium: Ein Gleichgewicht zwischen Geschwindigkeit und Genauigkeit.
- low: Optimiert für Effizienz und Geschwindigkeit.
- none: Deaktiviert den erweiterten Schlussfolgerungsprozess.
Das Modell verfügt außerdem über eine „Preserve Thinking“-Funktion, die den Denkverlauf aus früheren Gesprächsrunden beibehält, um bei längeren Interaktionen eine höhere Genauigkeit zu gewährleisten.