 Computer Forum
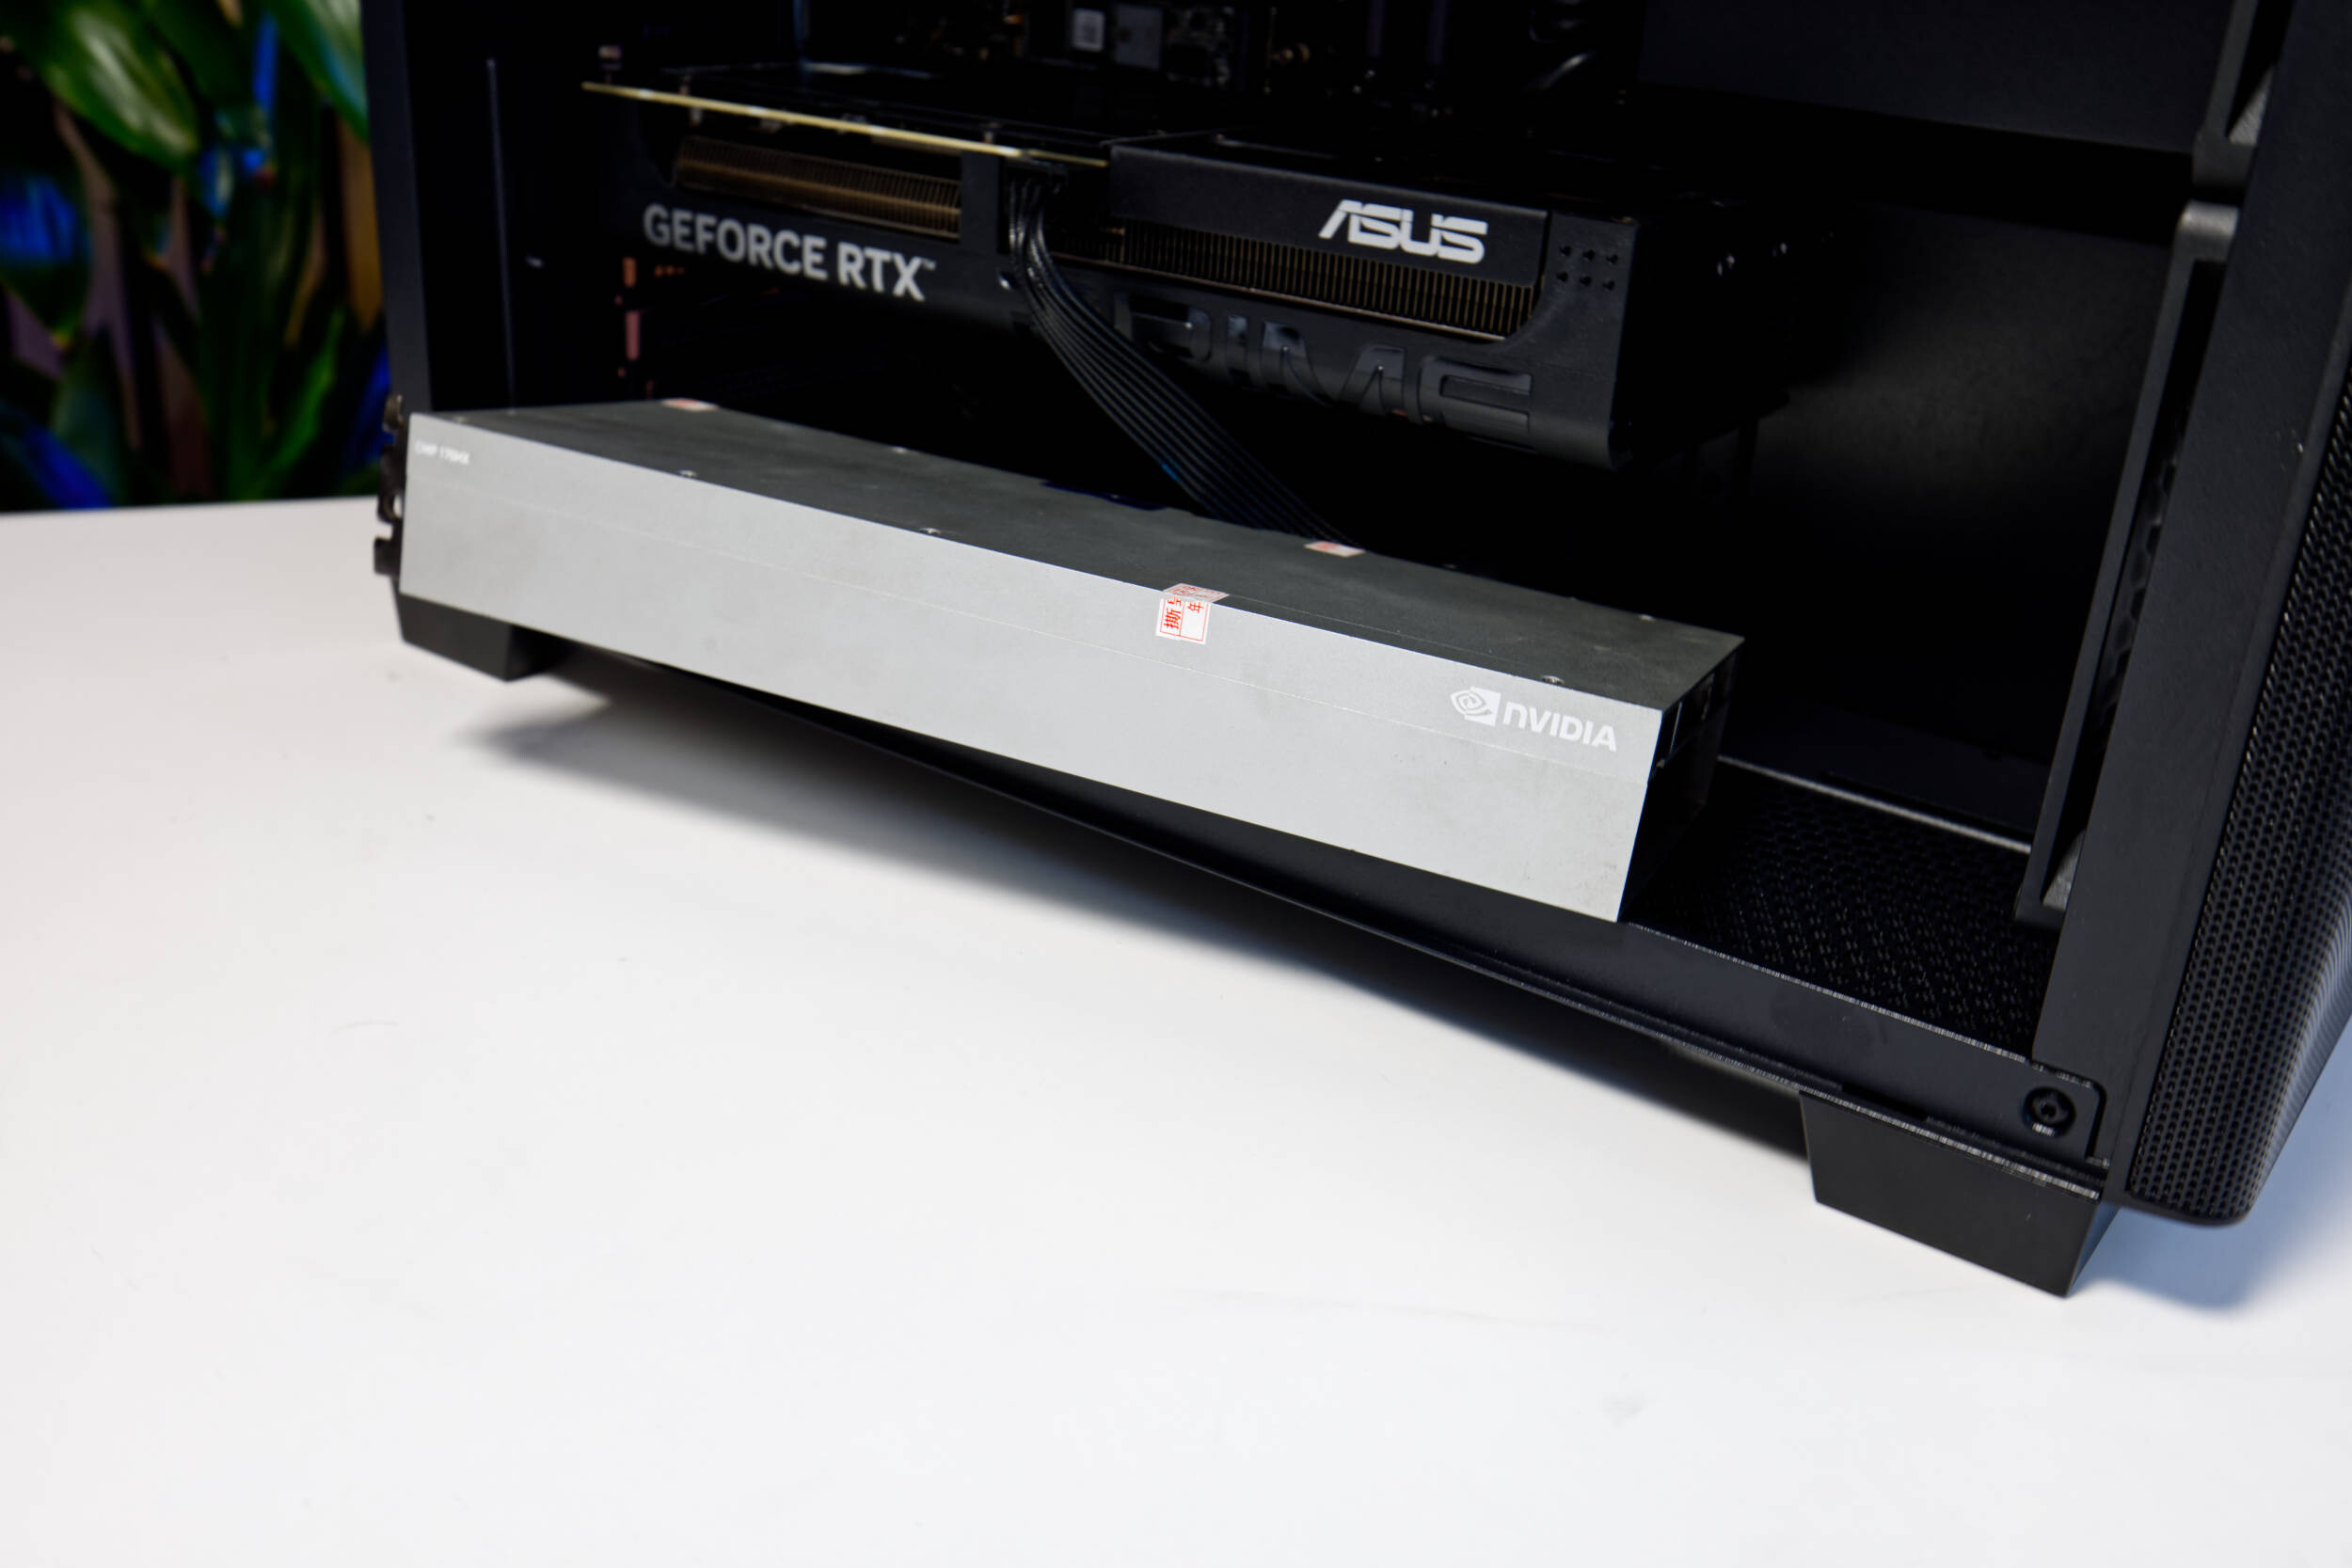 NVIDIA CMP 170HX Unlock (Bild © PCMasters.de)
Voltage Fault Injection und Fuse-Programmierung
Die neue Modifikation unterscheidet sich vom bisherigen softwarebasierten Unlock cmpunlocker, von dem wir berichteten und den wir auch verwendet haben bei unserer Karte. Bisher haben wir den Unlock von 8 GB auf 64 GB erreicht und einige wichtige Features wie ECC dadurch erhalten. Nun muss man aber weitergehen und einen Mikrocontroller nutzen, um während der Startsequenz der GPU Spannungsstörungen zu erzeugen.
Durch die Manipulation der Spannung in präzisen Intervallen konnte die Forscherin die mit der Fuse-Programmierung der GPU verbundenen Einschränkungen umgehen. Dies ermöglicht eine dauerhafte Neukonfiguration der GPU, wodurch sie Speicherpartitionen und Recheneinheiten erkennen und nutzen kann. Diese sind werkseitig deaktiviert worden. Der Speicher ist ab Werk vorhanden, da NVIDIA bei der Fertigung nicht den defekten HBM-Speicher entfernen kann. Er ist also vorhanden und dann anderweitig abgeriegelt.
Speicherkapazität und Recheneinheiten
Testergebnisse zeigen eine hohe Erfolgsquote bei der Speicherfreischaltung. Von zehn getesteten 8-GB-CMP-170HX-Einheiten konnten neun erfolgreich auf die volle Kapazität von 80 GB freigeschaltet werden, auch wenn eine Karte auf 64 GB begrenzt blieb. NVIDIA hat die Karten mit Schäden und solche, die den Ansprüchen von NVIDIA nicht entsprachen als solche abgewerteten Karten verkauft und so kann das Silizium auch fehlerhaft sein. Bei der 10-GB-Variante der Karte führte die Modifikation zu einer nutzbaren Speicherkapazität zwischen 40 GB und 48 GB.
Die Forscherin hat auch die Rechenressourcen der GPU erweitert. Die Anzahl der aktiven Streaming-Multiprozessoren (SMs) stieg von der werkseitigen Standardeinstellung von 70 auf 120 bis 126 Einheiten.
Was hat es gebracht?
Die Erhöhung der Recheneinheiten führt zu einer messbaren Leistungssteigerung bei Gleitkommaoperationen. In OpenCL-FP16-FMA-Benchmarks erreichte die modifizierte CMP 170HX 85,86 TFLOPS. Dieser Wert übertrifft die 72,49 TFLOPS, die für einen handelsüblichen NVIDIA A100-Beschleuniger gemessen wurden.
Um die Funktionalität der Karte noch stärker an professionelle Beschleuniger anzupassen, wurden zusätzliche Modifikationen auf Platinenebene vorgenommen, um Folgendes zu ermöglichen:
- PCIe-Gen4-Unterstützung für höhere Datenübertragungsraten.
- NVLink-Konnektivität für Multi-GPU-Skalierung.
Vor allem ist NVLink ein großes Extra, denn bei Verwendung mehreren solcher Karten ist die stark limitierte Bandbreite zwischen den Karten ein Bottleneck. Bisher ging man davon aus, dass NVLink durch fehlende Komponenten abgestellt wurde. Die technische Dokumentation, einschließlich Firmware- und Hardware-Designs, wurde über GitHub zur Verfügung gestellt, allerdings erfordert der Prozess physische Eingriffe in die Hardware und wiederholte Spannungsstörimpulse. Die Dokumentation ist auch sehr technisch.