 Computer Forum
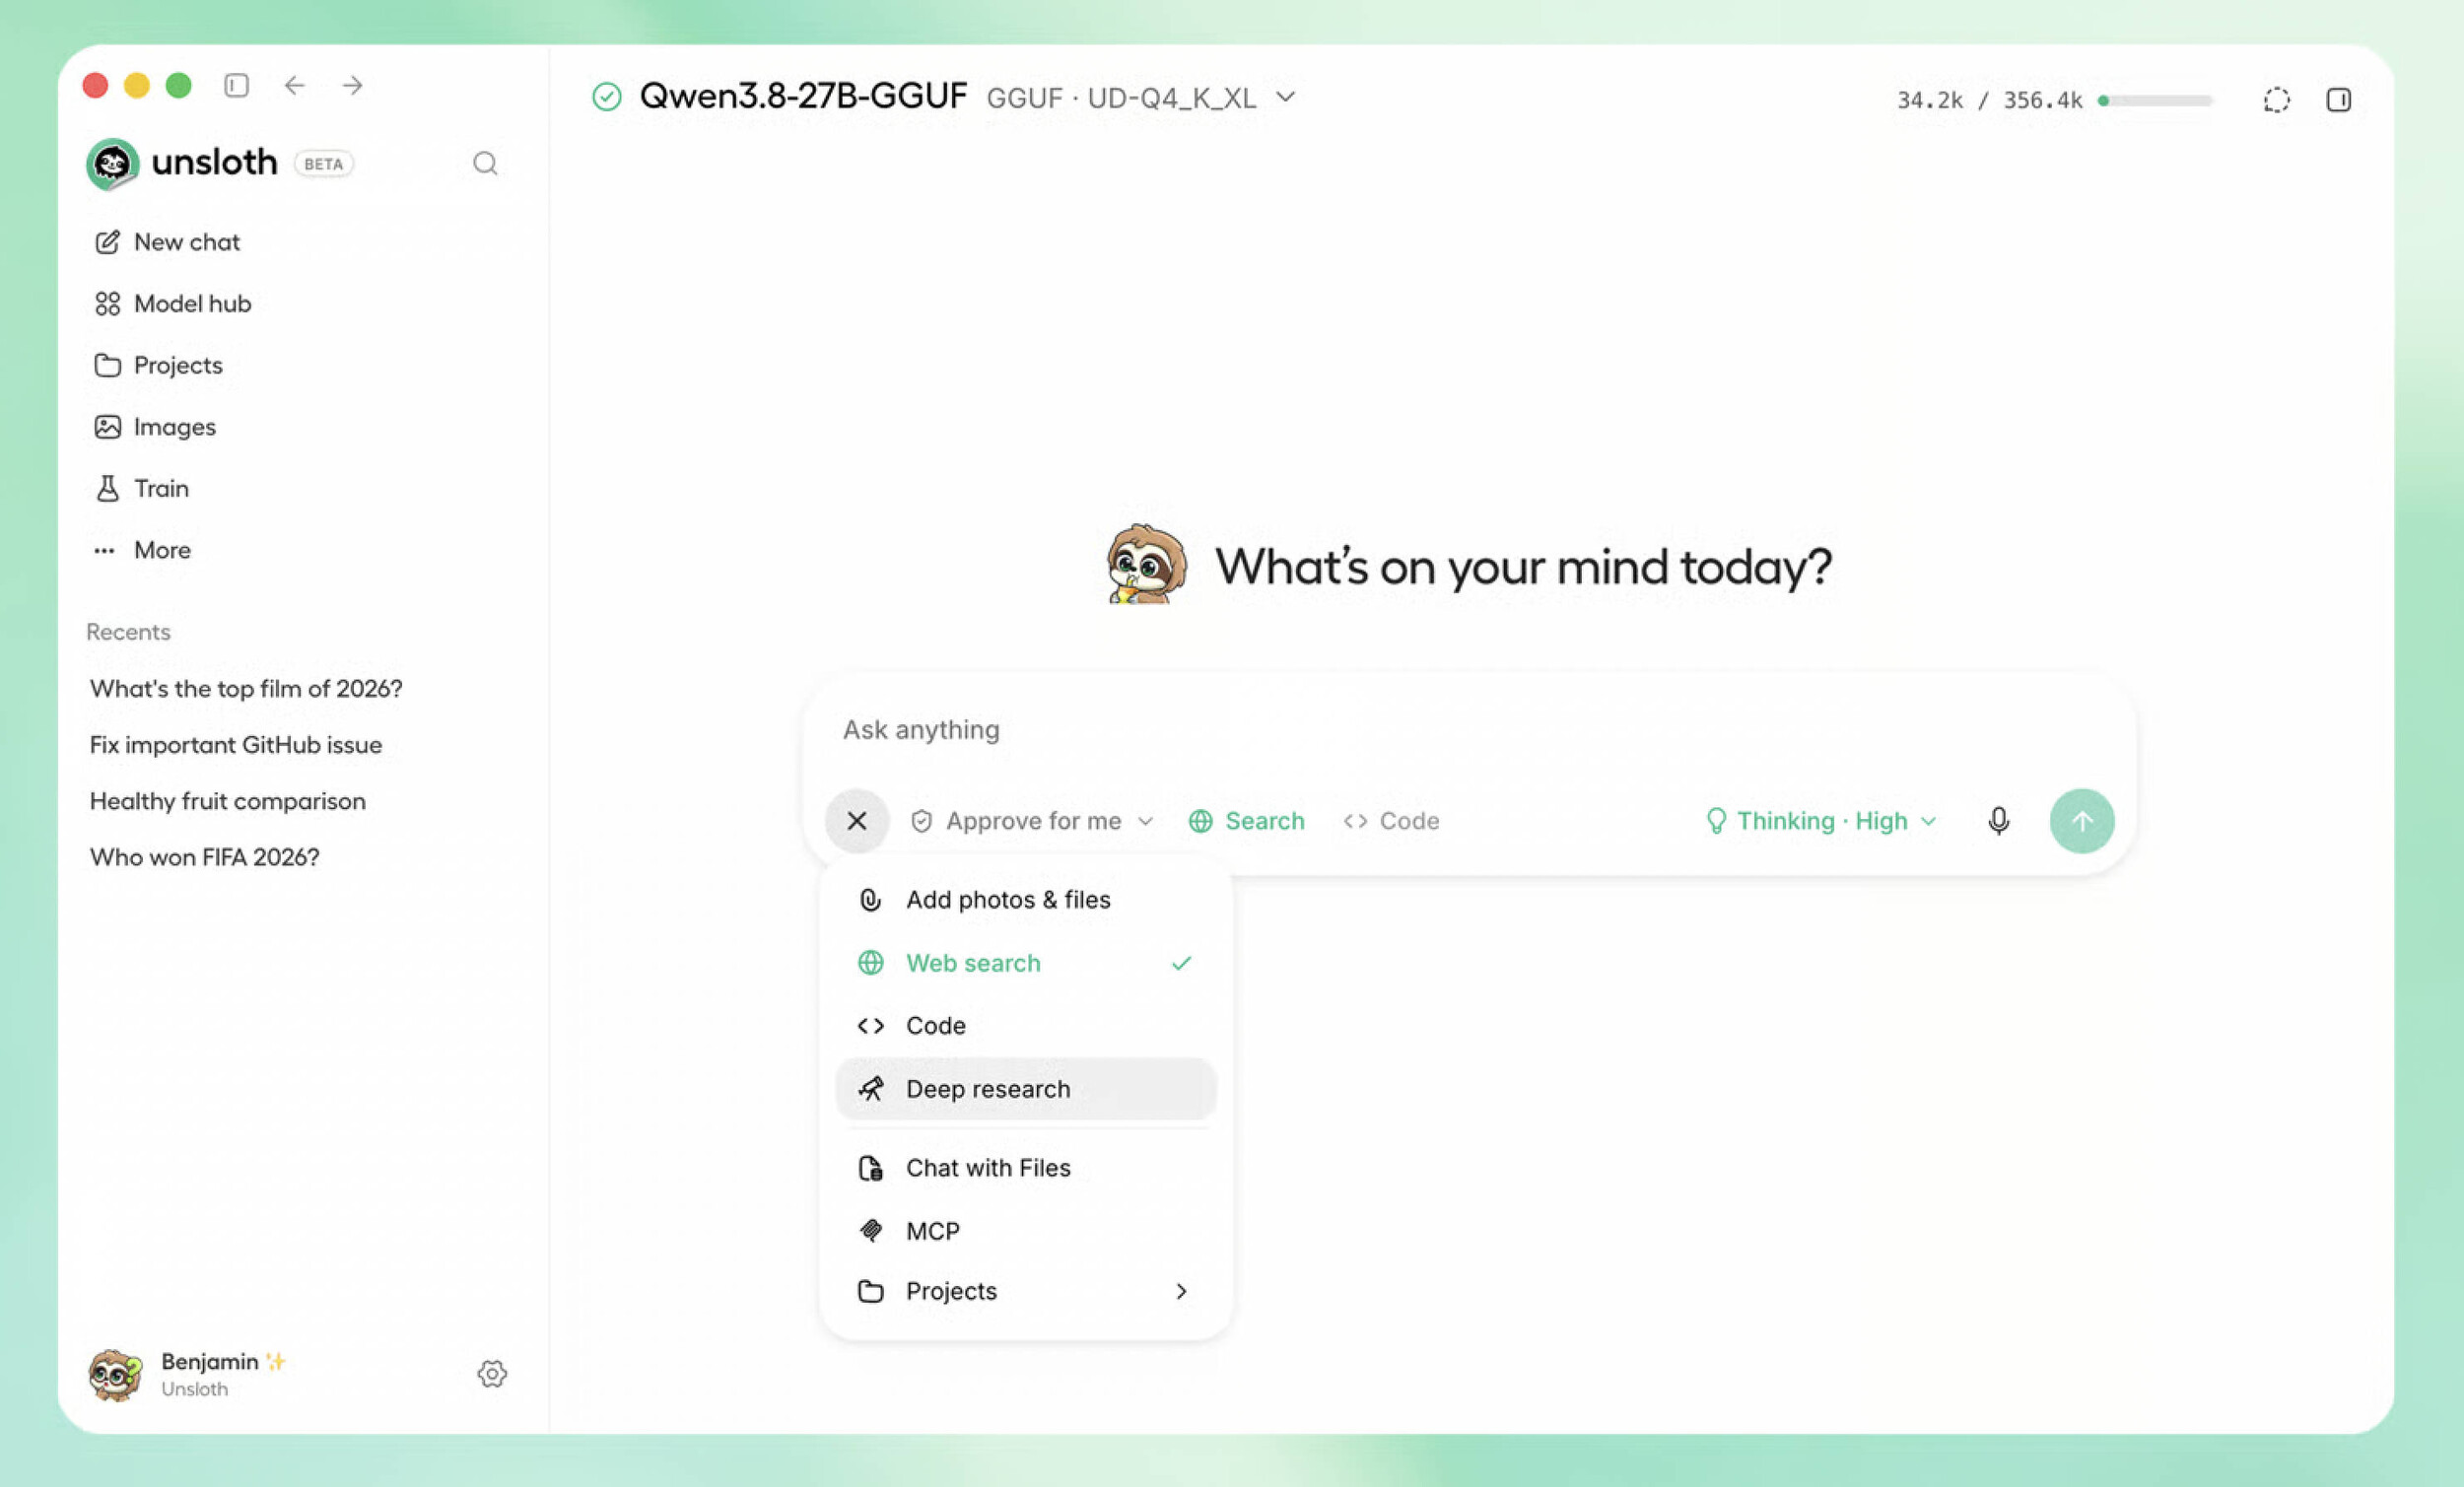 Unsloth Desktop (Bild © Unsloth)
NPU nutzen für lokale KI
Eine zentrale Komponente dieser Integration ist die Unsloth Desktop-API, die einen OpenAI-konformen ENd-Point bereitstellt. Dies ermöglicht eine Vielzahl kompatibler Software zu nutzen, die auf die NPU-Beschleunigung zurückgreifen. Derzeit können über 100 Agenten-Anwendungen und Workflows genutzt werden. Zu den nennenswerten kompatiblen Tools gehören:
- Entwicklungsumgebungen: VS Code und Cline.
- Agenten-Frameworks: Hermes Agent, OpenClaw und OMP.
- Benutzeroberflächen: Open WebUI.
Energieeffizienz und Verwaltung von Hardware-Ressourcen
Die Verlagerung von KI-Workloads auf die XDNA 2 NPU ist in erster Linie sparsam und schont die Ressourcen. So kann man bspw. die Text-to-Speach-Modelle auf die MPU auszulagern, um die GPU besser für große Modelle nutzen zu können.
Diese Umverteilung der Ressourcen bietet zwei wesentliche technische Vorteile:
- 1.Akkuschonung: Ein geringerer Stromverbrauch während der Inferenz verlängert die Betriebszeit mobiler Geräte.
- 2.Ressourcenverfügbarkeit: CPU- und GPU-Zyklen stehen weiterhin für andere gleichzeitig laufende Systemanwendungen zur Verfügung, vorausgesetzt.
Anleitung für NPU-Nutzung bei Unsloth Desktop
Die Ausführung von Unsloth Desktop auf einer AMD XDNA 2 NPU erfordert unter Windows einen spezifischen Einrichtungsprozess. Benutzer müssen zunächst Unsloth Desktop installieren, zum Modell-Hub navigieren und den NPU-Filter anwenden, um die Hardware zu aktivieren. Die Speicherzuweisung ist eine entscheidende Einschränkung für die lokale Inferenz. Die Menge des verfügbaren System-RAMs bestimmt, welche Modelle erfolgreich geladen werden können. Das Modell „Qwen 3.6 35B A3B“ erfordert beispielsweise etwa 28 GB Speicher, der der NPU zugewiesen wird. Da Windows standardmäßig in der Regel eine 50-prozentige gemeinsame Speicherzuweisung verwendet, muss ein System mit mindestens 64 GB Gesamtsystem-RAM ausgestattet sein, um ein Modell dieser Größe auszuführen.
Der Bereitstellungsprozess umfasst das Herunterladen des NPU-spezifischen Modells und dessen Auswahl im NPU-Bereich der Chat-Oberfläche, wo Benutzer auch das gewünschte Kontextfenster definieren können.
Leistung der lokalen Inferenz und MoE-Modelle
Die aktuelle Implementierung unterstützt die Ausführung komplexer Modellarchitekturen, einschließlich Mixture-of-Experts (MoE). Technische Demonstrationen haben bestätigt, dass das Qwen-3.6-Modell, das aus 35 Milliarden Parametern besteht, vollständig auf der lokalen NPU ausgeführt werden kann. Dieser Prozess wird durch die kombinierte Orchestrierung von Unsloth Desktop und der FLM-Inferenz-Engine ermöglicht, wodurch lokale KI mit hoher Parameteranzahl ohne Abhängigkeit von einer cloudbasierten Infrastruktur realisierbar ist.
CPUs und APUs mit XDNA 2 NPUs
Folgende Mobile und Desktop-Modelle sind mit einer XDNA2 NPU bestückt:
- Ryzen AI 9 HX 375, Ryzen AI 9 HX PRO 375, Ryzen AI 9 HX 370, Ryzen AI 9 HX PRO 370, Ryzen AI 9 365
- Ryzen AI 7 PRO 360, Ryzen AI 7 350, Ryzen AI 7 345
- Ryzen AI 5: Ryzen AI 5 340, Ryzen AI 5 330
- Ryzen AI 9 HX 475, Ryzen AI 7 450 und Ryzen AI 5 430
- Ryzen AI 7 450G/GE, Ryzen AI 5 440G/GE und Ryzen AI 5 435G/GE
- Ryzen AI Max+ 395, Ryzen AI Max 390 und Ryzen AI Max 385
- Ryzen AI Max+ PRO 495, Ryzen AI Max PRO 490 und Ryzen AI Max PRO 485
Wir werden passend einige NBU-Benchmarks damit demnächst diesem Artikel nachtragen.